






思路:先单线程爬虫,测试可以成功爬取之后再优化为多线程,最后存入数据库
以爬取郑州市租房信息为例
注意:本实战项目仅以学习为目的,为避免给网站造成太大压力,请将代码中的num修改成较小的数字,并将线程改小
一、单线程爬虫
# 用session取代requests
# 解析库使用bs4
# 并发库使用concurrent
import requests
# from lxml import etree    # 使用xpath解析
from bs4 import BeautifulSoup
from urllib import parse
import re
import time

headers = {
    'referer': 'https://zz.zu.fang.com/',
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.198 Safari/537.36',
    'cookie': 'global_cookie=ffzvt3kztwck05jm6twso2wjw18kl67hqft; city=zz; integratecover=1; __utma=147393320.427795962.1613371106.1613371106.1613371106.1; __utmc=147393320; __utmz=147393320.1613371106.1.1.utmcsr=zz.fang.com|utmccn=(referral)|utmcmd=referral|utmcct=/; __utmt_t0=1; __utmt_t1=1; __utmt_t2=1; ASP.NET_SessionId=aamzdnhzct4i5mx3ak4cyoyp; Rent_StatLog=23d82b94-13d6-4601-9019-ce0225c092f6; Captcha=61584F355169576F3355317957376E4F6F7552365351342B7574693561766E63785A70522F56557370586E3376585853346651565256574F37694B7074576B2B34536C5747715856516A4D3D; g_sourcepage=zf_fy%5Elb_pc; unique_cookie=U_ffzvt3kztwck05jm6twso2wjw18kl67hqft*6; __utmb=147393320.12.10.1613371106'
}
data={
    'agentbid':''
}

session = requests.session()
session.headers = headers

# 获取页面
def getHtml(url):
    try:
        re = session.get(url)
        re.encoding = re.apparent_encoding
        return re.text
    except:
        print(re.status_code)

# 获取页面总数量
def getNum(text):
    soup = BeautifulSoup(text, 'lxml')
    txt = soup.select('.fanye .txt')[0].text
    # 取出“共**页”中间的数字
    num = re.search(r'\d+', txt).group(0)
    return num

# 获取详细链接
def getLink(tex):
    soup=BeautifulSoup(text,'lxml')
    links=soup.select('.title a')
    for link in links:
        href=parse.urljoin('https://zz.zu.fang.com/',link['href'])
        hrefs.append(href)

# 解析页面
def parsePage(url):
    res=session.get(url)
    if res.status_code==200:
        res.encoding=res.apparent_encoding
        soup=BeautifulSoup(res.text,'lxml')
        try:
            title=soup.select('div .title')[0].text.strip().replace(' ','')
            price=soup.select('div .trl-item')[0].text.strip()
            block=soup.select('.rcont #agantzfxq_C02_08')[0].text.strip()
            building=soup.select('.rcont #agantzfxq_C02_07')[0].text.strip()
            try:
                address=soup.select('.trl-item2 .rcont')[2].text.strip()
            except:
                address=soup.select('.trl-item2 .rcont')[1].text.strip()
            detail1=soup.select('.clearfix')[4].text.strip().replace('\n\n\n',',').replace('\n','')
            detail2=soup.select('.clearfix')[5].text.strip().replace('\n\n\n',',').replace('\n','')
            detail=detail1+detail2
            name=soup.select('.zf_jjname')[0].text.strip()
            buserid=re.search('buserid: \'(\d+)\'',res.text).group(1)
            phone=getPhone(buserid)
            print(title,price,block,building,address,detail,name,phone)
            house = (title, price, block, building, address, detail, name, phone)
            info.append(house)
        except:
            pass
    else:
        print(re.status_code,re.text)

# 获取代理人号码
def getPhone(buserid):
    url='https://zz.zu.fang.com/RentDetails/Ajax/GetAgentVirtualMobile.aspx'
    data['agentbid']=buserid
    res=session.post(url,data=data)
    if res.status_code==200:
        return res.text
    else:
        print(res.status_code)
        return

if __name__ == '__main__':
    start_time=time.time()
    hrefs=[]
    info=[]
    init_url = 'https://zz.zu.fang.com/house/'
    num=getNum(getHtml(init_url))
    for i in range(0,num):
        url = f'https://zz.zu.fang.com/house/i3{i+1}/'
        text=getHtml(url)
        getLink(text)
    print(hrefs)
    for href in hrefs:
        parsePage(href)

    print("共获取%d条数据"%len(info))
    print("共耗时{}".format(time.time()-start_time))
    session.close()
二、优化为多线程爬虫
# 用session取代requests
# 解析库使用bs4
# 并发库使用concurrent
import requests
# from lxml import etree    # 使用xpath解析
from bs4 import BeautifulSoup
from concurrent.futures import ThreadPoolExecutor
from urllib import parse
import re
import time

headers = {
    'referer': 'https://zz.zu.fang.com/',
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.198 Safari/537.36',
    'cookie': 'global_cookie=ffzvt3kztwck05jm6twso2wjw18kl67hqft; integratecover=1; city=zz; keyWord_recenthousezz=[%7b%22name%22%3a%22%e6%96%b0%e5%af%86%22%2c%22detailName%22%3a%22%22%2c%22url%22%3a%22%2fhouse-a014868%2f%22%2c%22sort%22%3a1%7d%2c%7b%22name%22%3a%22%e4%ba%8c%e4%b8%83%22%2c%22detailName%22%3a%22%22%2c%22url%22%3a%22%2fhouse-a014864%2f%22%2c%22sort%22%3a1%7d%2c%7b%22name%22%3a%22%e9%83%91%e4%b8%9c%e6%96%b0%e5%8c%ba%22%2c%22detailName%22%3a%22%22%2c%22url%22%3a%22%2fhouse-a0842%2f%22%2c%22sort%22%3a1%7d]; __utma=147393320.427795962.1613371106.1613558547.1613575774.5; __utmc=147393320; __utmz=147393320.1613575774.5.4.utmcsr=zz.fang.com|utmccn=(referral)|utmcmd=referral|utmcct=/; ASP.NET_SessionId=vhrhxr1tdatcc1xyoxwybuwv; g_sourcepage=zf_fy%5Elb_pc; Captcha=4937566532507336644D6557347143746B5A6A6B4A7A48445A422F2F6A51746C67516F31357446573052634562725162316152533247514250736F72775566574A2B33514357304B6976343D; __utmt_t0=1; __utmt_t1=1; __utmt_t2=1; __utmb=147393320.9.10.1613575774; unique_cookie=U_0l0d1ilf1t0ci2rozai9qi24k1pkl9lcmrs*4'
}
data={
    'agentbid':''
}

session = requests.session()
session.headers = headers

# 获取页面
def getHtml(url):
    res = session.get(url)
    if res.status_code==200:
        res.encoding = res.apparent_encoding
        return res.text
    else:
        print(res.status_code)

# 获取页面总数量
def getNum(text):
    soup = BeautifulSoup(text, 'lxml')
    txt = soup.select('.fanye .txt')[0].text
    # 取出“共**页”中间的数字
    num = re.search(r'\d+', txt).group(0)
    return num

# 获取详细链接
def getLink(url):
    text=getHtml(url)
    soup=BeautifulSoup(text,'lxml')
    links=soup.select('.title a')
    for link in links:
        href=parse.urljoin('https://zz.zu.fang.com/',link['href'])
        hrefs.append(href)

# 解析页面
def parsePage(url):
    res=session.get(url)
    if res.status_code==200:
        res.encoding=res.apparent_encoding
        soup=BeautifulSoup(res.text,'lxml')
        try:
            title=soup.select('div .title')[0].text.strip().replace(' ','')
            price=soup.select('div .trl-item')[0].text.strip()
            block=soup.select('.rcont #agantzfxq_C02_08')[0].text.strip()
            building=soup.select('.rcont #agantzfxq_C02_07')[0].text.strip()
            try:
                address=soup.select('.trl-item2 .rcont')[2].text.strip()
            except:
                address=soup.select('.trl-item2 .rcont')[1].text.strip()
            detail1=soup.select('.clearfix')[4].text.strip().replace('\n\n\n',',').replace('\n','')
            detail2=soup.select('.clearfix')[5].text.strip().replace('\n\n\n',',').replace('\n','')
            detail=detail1+detail2
            name=soup.select('.zf_jjname')[0].text.strip()
            buserid=re.search('buserid: \'(\d+)\'',res.text).group(1)
            phone=getPhone(buserid)
            print(title,price,block,building,address,detail,name,phone)
            house = (title, price, block, building, address, detail, name, phone)
            info.append(house)
        except:
            pass
    else:
        print(re.status_code,re.text)

# 获取代理人号码
def getPhone(buserid):
    url='https://zz.zu.fang.com/RentDetails/Ajax/GetAgentVirtualMobile.aspx'
    data['agentbid']=buserid
    res=session.post(url,data=data)
    if res.status_code==200:
        return res.text
    else:
        print(res.status_code)
        return

if __name__ == '__main__':
    start_time=time.time()
    hrefs=[]
    info=[]
    init_url = 'https://zz.zu.fang.com/house/'
    num=getNum(getHtml(init_url))
    with ThreadPoolExecutor(max_workers=5) as t:
        for i in range(0,num):
            url = f'https://zz.zu.fang.com/house/i3{i+1}/'
            t.submit(getLink,url)
    print("共获取%d个链接"%len(hrefs))
    print(hrefs)
    with ThreadPoolExecutor(max_workers=30) as t:
        for href in hrefs:
            t.submit(parsePage,href)
    print("共获取%d条数据"%len(info))
    print("耗时{}".format(time.time()-start_time))
    session.close()
三、使用asyncio进一步优化
# 用session取代requests
# 解析库使用bs4
# 并发库使用concurrent
import requests
# from lxml import etree    # 使用xpath解析
from bs4 import BeautifulSoup
from concurrent.futures import ThreadPoolExecutor
from urllib import parse
import re
import time
import asyncio

headers = {
    'referer': 'https://zz.zu.fang.com/',
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.198 Safari/537.36',
    'cookie': 'global_cookie=ffzvt3kztwck05jm6twso2wjw18kl67hqft; integratecover=1; city=zz; keyWord_recenthousezz=[%7b%22name%22%3a%22%e6%96%b0%e5%af%86%22%2c%22detailName%22%3a%22%22%2c%22url%22%3a%22%2fhouse-a014868%2f%22%2c%22sort%22%3a1%7d%2c%7b%22name%22%3a%22%e4%ba%8c%e4%b8%83%22%2c%22detailName%22%3a%22%22%2c%22url%22%3a%22%2fhouse-a014864%2f%22%2c%22sort%22%3a1%7d%2c%7b%22name%22%3a%22%e9%83%91%e4%b8%9c%e6%96%b0%e5%8c%ba%22%2c%22detailName%22%3a%22%22%2c%22url%22%3a%22%2fhouse-a0842%2f%22%2c%22sort%22%3a1%7d]; __utma=147393320.427795962.1613371106.1613558547.1613575774.5; __utmc=147393320; __utmz=147393320.1613575774.5.4.utmcsr=zz.fang.com|utmccn=(referral)|utmcmd=referral|utmcct=/; ASP.NET_SessionId=vhrhxr1tdatcc1xyoxwybuwv; g_sourcepage=zf_fy%5Elb_pc; Captcha=4937566532507336644D6557347143746B5A6A6B4A7A48445A422F2F6A51746C67516F31357446573052634562725162316152533247514250736F72775566574A2B33514357304B6976343D; __utmt_t0=1; __utmt_t1=1; __utmt_t2=1; __utmb=147393320.9.10.1613575774; unique_cookie=U_0l0d1ilf1t0ci2rozai9qi24k1pkl9lcmrs*4'
}
data={
    'agentbid':''
}

session = requests.session()
session.headers = headers

# 获取页面
def getHtml(url):
    res = session.get(url)
    if res.status_code==200:
        res.encoding = res.apparent_encoding
        return res.text
    else:
        print(res.status_code)

# 获取页面总数量
def getNum(text):
    soup = BeautifulSoup(text, 'lxml')
    txt = soup.select('.fanye .txt')[0].text
    # 取出“共**页”中间的数字
    num = re.search(r'\d+', txt).group(0)
    return num

# 获取详细链接
def getLink(url):
    text=getHtml(url)
    soup=BeautifulSoup(text,'lxml')
    links=soup.select('.title a')
    for link in links:
        href=parse.urljoin('https://zz.zu.fang.com/',link['href'])
        hrefs.append(href)

# 解析页面
def parsePage(url):
    res=session.get(url)
    if res.status_code==200:
        res.encoding=res.apparent_encoding
        soup=BeautifulSoup(res.text,'lxml')
        try:
            title=soup.select('div .title')[0].text.strip().replace(' ','')
            price=soup.select('div .trl-item')[0].text.strip()
            block=soup.select('.rcont #agantzfxq_C02_08')[0].text.strip()
            building=soup.select('.rcont #agantzfxq_C02_07')[0].text.strip()
            try:
                address=soup.select('.trl-item2 .rcont')[2].text.strip()
            except:
                address=soup.select('.trl-item2 .rcont')[1].text.strip()
            detail1=soup.select('.clearfix')[4].text.strip().replace('\n\n\n',',').replace('\n','')
            detail2=soup.select('.clearfix')[5].text.strip().replace('\n\n\n',',').replace('\n','')
            detail=detail1+detail2
            name=soup.select('.zf_jjname')[0].text.strip()
            buserid=re.search('buserid: \'(\d+)\'',res.text).group(1)
            phone=getPhone(buserid)
            print(title,price,block,building,address,detail,name,phone)
            house = (title, price, block, building, address, detail, name, phone)
            info.append(house)
        except:
            pass
    else:
        print(re.status_code,re.text)

# 获取代理人号码
def getPhone(buserid):
    url='https://zz.zu.fang.com/RentDetails/Ajax/GetAgentVirtualMobile.aspx'
    data['agentbid']=buserid
    res=session.post(url,data=data)
    if res.status_code==200:
        return res.text
    else:
        print(res.status_code)
        return

# 获取详细链接的线程池
async def Pool1(num):
    loop=asyncio.get_event_loop()
    task=[]
    with ThreadPoolExecutor(max_workers=5) as t:
        for i in range(0,num):
            url = f'https://zz.zu.fang.com/house/i3{i+1}/'
            task.append(loop.run_in_executor(t,getLink,url))

# 解析页面的线程池
async def Pool2(hrefs):
    loop=asyncio.get_event_loop()
    task=[]
    with ThreadPoolExecutor(max_workers=30) as t:
        for href in hrefs:
            task.append(loop.run_in_executor(t,parsePage,href))

if __name__ == '__main__':
    start_time=time.time()
    hrefs=[]
    info=[]
    task=[]
    init_url = 'https://zz.zu.fang.com/house/'
    num=getNum(getHtml(init_url))
    loop = asyncio.get_event_loop()
    loop.run_until_complete(Pool1(num))
    print("共获取%d个链接"%len(hrefs))
    print(hrefs)
    loop.run_until_complete(Pool2(hrefs))
    loop.close()
    print("共获取%d条数据"%len(info))
    print("耗时{}".format(time.time()-start_time))
    session.close()
四、存入Mysql数据库
(一)建表
from sqlalchemy import create_engine
from sqlalchemy import String, Integer, Column, Text
from sqlalchemy.orm import sessionmaker
from sqlalchemy.orm import scoped_session  # 多线程爬虫时避免出现线程安全问题
from sqlalchemy.ext.declarative import declarative_base

BASE = declarative_base()  # 实例化
engine = create_engine(
    "mysql+pymysql://root:root@127.0.0.1:3306/pytest?charset=utf8",
    max_overflow=300,  # 超出连接池大小最多可以创建的连接
    pool_size=100,  # 连接池大小
    echo=False,  # 不显示调试信息
)


class House(BASE):
    __tablename__ = 'house'
    id = Column(Integer, primary_key=True, autoincrement=True)
    title=Column(String(200))
    price=Column(String(200))
    block=Column(String(200))
    building=Column(String(200))
    address=Column(String(200))
    detail=Column(Text())
    name=Column(String(20))
    phone=Column(String(20))


BASE.metadata.create_all(engine)
Session = sessionmaker(engine)
sess = scoped_session(Session)
(二)将数据存入数据库中
# 用session取代requests
# 解析库使用bs4
# 并发库使用concurrent
import requests
from bs4 import BeautifulSoup
from concurrent.futures import ThreadPoolExecutor
from urllib import parse
from mysqldb import sess, House
import re
import time
import asyncio

headers = {
    'referer': 'https://zz.zu.fang.com/',
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.198 Safari/537.36',
    'cookie': 'global_cookie=ffzvt3kztwck05jm6twso2wjw18kl67hqft; integratecover=1; city=zz; __utmc=147393320; ASP.NET_SessionId=vhrhxr1tdatcc1xyoxwybuwv; __utma=147393320.427795962.1613371106.1613575774.1613580597.6; __utmz=147393320.1613580597.6.5.utmcsr=zz.fang.com|utmccn=(referral)|utmcmd=referral|utmcct=/; __utmt_t0=1; __utmt_t1=1; __utmt_t2=1; Rent_StatLog=c158b2a7-4622-45a9-9e69-dcf6f42cf577; keyWord_recenthousezz=[%7b%22name%22%3a%22%e4%ba%8c%e4%b8%83%22%2c%22detailName%22%3a%22%22%2c%22url%22%3a%22%2fhouse-a014864%2f%22%2c%22sort%22%3a1%7d%2c%7b%22name%22%3a%22%e9%83%91%e4%b8%9c%e6%96%b0%e5%8c%ba%22%2c%22detailName%22%3a%22%22%2c%22url%22%3a%22%2fhouse-a0842%2f%22%2c%22sort%22%3a1%7d%2c%7b%22name%22%3a%22%e7%bb%8f%e5%bc%80%22%2c%22detailName%22%3a%22%22%2c%22url%22%3a%22%2fhouse-a014871%2f%22%2c%22sort%22%3a1%7d]; g_sourcepage=zf_fy%5Elb_pc; Captcha=6B65716A41454739794D666864397178613772676C75447A4E746C657144775A347A6D42554F446532357649643062344F6976756E563450554E59594B7833712B413579506C4B684958343D; unique_cookie=U_0l0d1ilf1t0ci2rozai9qi24k1pkl9lcmrs*14; __utmb=147393320.21.10.1613580597'
}
data={
    'agentbid':''
}

session = requests.session()
session.headers = headers

# 获取页面
def getHtml(url):
    res = session.get(url)
    if res.status_code==200:
        res.encoding = res.apparent_encoding
        return res.text
    else:
        print(res.status_code)

# 获取页面总数量
def getNum(text):
    soup = BeautifulSoup(text, 'lxml')
    txt = soup.select('.fanye .txt')[0].text
    # 取出“共**页”中间的数字
    num = re.search(r'\d+', txt).group(0)
    return num

# 获取详细链接
def getLink(url):
    text=getHtml(url)
    soup=BeautifulSoup(text,'lxml')
    links=soup.select('.title a')
    for link in links:
        href=parse.urljoin('https://zz.zu.fang.com/',link['href'])
        hrefs.append(href)

# 解析页面
def parsePage(url):
    res=session.get(url)
    if res.status_code==200:
        res.encoding=res.apparent_encoding
        soup=BeautifulSoup(res.text,'lxml')
        try:
            title=soup.select('div .title')[0].text.strip().replace(' ','')
            price=soup.select('div .trl-item')[0].text.strip()
            block=soup.select('.rcont #agantzfxq_C02_08')[0].text.strip()
            building=soup.select('.rcont #agantzfxq_C02_07')[0].text.strip()
            try:
                address=soup.select('.trl-item2 .rcont')[2].text.strip()
            except:
                address=soup.select('.trl-item2 .rcont')[1].text.strip()
            detail1=soup.select('.clearfix')[4].text.strip().replace('\n\n\n',',').replace('\n','')
            detail2=soup.select('.clearfix')[5].text.strip().replace('\n\n\n',',').replace('\n','')
            detail=detail1+detail2
            name=soup.select('.zf_jjname')[0].text.strip()
            buserid=re.search('buserid: \'(\d+)\'',res.text).group(1)
            phone=getPhone(buserid)
            print(title,price,block,building,address,detail,name,phone)
            house = (title, price, block, building, address, detail, name, phone)
            info.append(house)
            try:
                house_data=House(
                    title=title,
                    price=price,
                    block=block,
                    building=building,
                    address=address,
                    detail=detail,
                    name=name,
                    phone=phone
                )
                sess.add(house_data)
                sess.commit()
            except Exception as e:
                print(e)    # 打印错误信息
                sess.rollback()  # 回滚
        except:
            pass
    else:
        print(re.status_code,re.text)

# 获取代理人号码
def getPhone(buserid):
    url='https://zz.zu.fang.com/RentDetails/Ajax/GetAgentVirtualMobile.aspx'
    data['agentbid']=buserid
    res=session.post(url,data=data)
    if res.status_code==200:
        return res.text
    else:
        print(res.status_code)
        return

# 获取详细链接的线程池
async def Pool1(num):
    loop=asyncio.get_event_loop()
    task=[]
    with ThreadPoolExecutor(max_workers=5) as t:
        for i in range(0,num):
            url = f'https://zz.zu.fang.com/house/i3{i+1}/'
            task.append(loop.run_in_executor(t,getLink,url))

# 解析页面的线程池
async def Pool2(hrefs):
    loop=asyncio.get_event_loop()
    task=[]
    with ThreadPoolExecutor(max_workers=30) as t:
        for href in hrefs:
            task.append(loop.run_in_executor(t,parsePage,href))

if __name__ == '__main__':
    start_time=time.time()
    hrefs=[]
    info=[]
    task=[]
    init_url = 'https://zz.zu.fang.com/house/'
    num=getNum(getHtml(init_url))
    loop = asyncio.get_event_loop()
    loop.run_until_complete(Pool1(num))
    print("共获取%d个链接"%len(hrefs))
    print(hrefs)
    loop.run_until_complete(Pool2(hrefs))
    loop.close()
    print("共获取%d条数据"%len(info))
    print("耗时{}".format(time.time()-start_time))
    session.close()
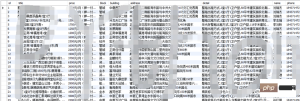
五、最终效果图 (已打码)

使用 Claude Agent SDK 将绑定的 Claude 代码会话嵌入到 Python 自动化中
下载
当现有的脚本或服务需要将作用域化的仓库工作委托给 Claude Code 并以编程方式消费结构化响应时,请使用 Claude Agent SDK for Python。
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!














