






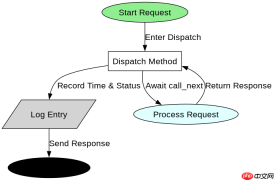
starlette 记录请求日志的标准做法是注册一个中间件,在请求进入应用前记录时间戳和元数据,并在响应返回后计算耗时并输出日志。具体实现时,需要继承 starlette.middleware.base.basehttpmiddleware 或实现 asgiapp 协议,通过调用 await call_next(request) 获取响应对象,随后使用 python 标准库的 logging 模块将请求方法、路径、状态码及处理时长写入日志文件。这样做能确保所有经过该应用的请求都被统一捕获,且不会侵入业务逻辑代码。
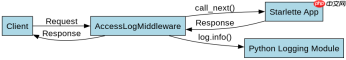
如何自定义中间件以捕获请求详情
要实现这一功能,开发者需创建一个类并重写 async __call__ 方法。在该方法中,先记录当前时间,然后调用 super().__call__(scope, receive, send) 执行后续逻辑,最后记录结束时间并格式化输出日志信息。关键在于使用 logging.getLogger(__name__).info() 来生成结构化日志,便于后续分析。
import logging
import time
from starlette.middleware.base import BaseHTTPMiddleware
from starlette.requests import Request
from starlette.responses import Response

logger = logging.getLogger("starlette.access")

class AccessLogMiddleware(BaseHTTPMiddleware):
    async def dispatch(self, request: Request, call_next):
        start_time = time.time()
        response = await call_next(request)
        process_time = time.time() - start_time
        logger.info(
            f"{request.method} {request.url.path} {response.status_code} {process_time:.4f}s"
        )
        return response
上述代码定义了一个名为 AccessLogMiddleware 的中间件。当应用启动时,通过 app.add_middleware(AccessLogMiddleware) 将其注册。对于每个请求,它会打印类似 GET /api/users 200 0.0123s 的日志行。若需更详细的日志,可加入 request.headers 中的用户代理或客户端 IP 地址。注意,call_next 必须被正确 await,否则响应无法完整返回。
如何处理异常导致的日志缺失
当请求在处理过程中抛出未捕获异常时,默认行为可能导致日志不完整或丢失。为解决此问题,应在中间件的 try...except 块中捕获异常,并记录错误堆栈。这样即使响应失败,也能保留完整的请求上下文信息,便于排查故障。
Starlette 1.5.1 是轻量级 Python ASGI 框架与工具集,提供路由、请求响应、中间件、WebSocket 和后台任务等组件,适合构建异步 Web 服务。本下载为官方 PyPI 通用 wheel 包,可使用 pip 安装,并由包管理器处理依赖;运行应用时还需配置 ASGI 服务器。

import traceback
import logging
import time
from starlette.middleware.base import BaseHTTPMiddleware
from starlette.requests import Request
from starlette.responses import JSONResponse

logger = logging.getLogger("starlette.error")

class ErrorLoggingMiddleware(BaseHTTPMiddleware):
    async def dispatch(self, request: Request, call_next):
        try:
            start_time = time.time()
            response = await call_next(request)
            process_time = time.time() - start_time
            if response.status_code >= 400:
                logger.warning(
                    f"Error: {request.method} {request.url.path} {response.status_code} {process_time:.4f}s"
                )
            return response
        except Exception as e:
            process_time = time.time() - start_time
            logger.error(
                f"Exception: {request.method} {request.url.path} {process_time:.4f}s\n"
                + "".join(traceback.format_exception(type(e), e, e.__traceback__))
            )
            return JSONResponse(
                status_code=500,
                content={"detail": "Internal Server Error"}
            )
该中间件在捕获到异常时,会记录完整的堆栈跟踪信息,并返回一个标准的 500 错误响应。这确保了即使在系统崩溃边缘,关键诊断数据也不会丢失。开发者可根据需要调整日志级别,例如将 warning 改为 error 以区分严重性。此外,JSONResponse 的使用保证了 API 客户端收到合法的 JSON 格式错误响应,符合 RESTful 规范。
基于特定输入条件如何优化日志性能
在高并发场景下,频繁的文件 I/O 可能成为瓶颈。为优化性能,可采用异步日志记录器或批量写入策略。例如,使用 aiologger 库替代标准 logging,或在中间件中缓存日志条目,定期 flush 到磁盘。此外,可对高频路径设置采样率,避免重复记录相同模式的请求。
在实际应用中,若发现日志写入延迟影响响应时间,可考虑将日志发送至外部监控系统如 ELK 或 Prometheus,而非直接写入本地文件。这种架构分离能有效降低主线程阻塞风险,提升整体吞吐量。开发者应根据实际负载测试选择合适方案,平衡可观测性与系统性能。









