






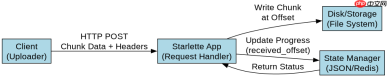
starlette 本身不直接提供分片上传的专用 api,而是通过流式读取请求体来实现。开发者需要监听 receive 事件,识别客户端发送的分片数据,并根据业务逻辑将数据写入磁盘或存储桶。通常的做法是结合 http 头信息(如 content-range)来管理分片的顺序和完整性。
如何解析 Content-Range 头以定位文件位置
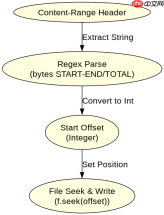
在分片上传中,每个 HTTP 请求都会携带 Content-Range 头,用于告知服务器当前片段在整个文件中的字节偏移量。Starlette 的 Request 对象可以通过 headers.get() 方法轻松获取该值。解析这个字符串可以计算出当前片段的起始偏移量,从而确保数据被正确追加到文件的指定位置。
import re
from starlette.applications import Starlette
from starlette.responses import JSONResponse
from starlette.requests import Request
import os

# 配置
UPLOAD_DIR = "./uploads"
os.makedirs(UPLOAD_DIR, exist_ok=True)

def parse_content_range(content_range: str) -> int:
    # 格式示例: bytes 0-499/10000
    match = re.match(r"bytes (\d+)-.*", content_range)
    if match:
        return int(match.group(1))
    return 0

app = Starlette()

@app.post("/upload")
async def upload_chunk(request: Request):
    file_id = request.headers.get("X-File-ID", "default")
    content_range = request.headers.get("Content-Range")

    if not content_range:
        return JSONResponse({"error": "Missing Content-Range"}, status_code=400)

    offset = parse_content_range(content_range)
    chunk_data = await request.body()

    file_path = os.path.join(UPLOAD_DIR, f"{file_id}.tmp")

    with open(file_path, "ab") as f:
        f.seek(offset)
        f.write(chunk_data)

    return JSONResponse({"status": "chunk received", "offset": offset})
上述代码展示了如何从请求中提取 Content-Range 并解析出偏移量。关键点在于使用 await request.body() 获取当前请求体的二进制数据,然后使用 Python 标准库的文件操作进行定位写入。这种方式避免了将整个文件加载到内存中,适合处理大文件。
如何管理多个并发上传会话的状态
当多个用户同时上传文件时,需要一种机制来区分不同的上传会话。通常使用唯一的 file_id 作为标识符。在 Starlette 应用中,可以使用简单的字典或外部存储(如 Redis)来跟踪每个 file_id 的上传进度。对于简单的本地实现,可以在每次收到新分片时更新一个状态文件,记录已接收的最大偏移量,以便客户端查询进度或服务器在重启后恢复状态。
Starlette 1.5.1 是轻量级 Python ASGI 框架与工具集,提供路由、请求响应、中间件、WebSocket 和后台任务等组件,适合构建异步 Web 服务。本下载为官方 PyPI 通用 wheel 包,可使用 pip 安装,并由包管理器处理依赖;运行应用时还需配置 ASGI 服务器。

import json
import os
from starlette.applications import Starlette
from starlette.responses import JSONResponse
from starlette.requests import Request

STATE_DIR = "./state"
os.makedirs(STATE_DIR, exist_ok=True)

def get_state_file(file_id: str) -> str:
    return os.path.join(STATE_DIR, f"{file_id}.json")

def load_state(file_id: str) -> dict:
    path = get_state_file(file_id)
    if os.path.exists(path):
        with open(path, "r") as f:
            return json.load(f)
    return {"file_id": file_id, "total_size": 0, "received_offset": 0}

def save_state(file_id: str, state: dict):
    path = get_state_file(file_id)
    with open(path, "w") as f:
        json.dump(state, f)

app = Starlette()

@app.post("/upload")
async def upload_chunk_with_state(request: Request):
    file_id = request.headers.get("X-File-ID", "default")
    content_range = request.headers.get("Content-Range")
    total_size_header = request.headers.get("Content-Length")

    state = load_state(file_id)

    if content_range:
        offset = parse_content_range(content_range)
        chunk_data = await request.body()

        file_path = os.path.join(UPLOAD_DIR, f"{file_id}.tmp")
        with open(file_path, "ab") as f:
            f.seek(offset)
            f.write(chunk_data)

        state["received_offset"] = max(state["received_offset"], offset + len(chunk_data))

    if total_size_header:
        state["total_size"] = int(total_size_header)

    save_state(file_id, state)

    return JSONResponse({"status": "ok", "progress": state["received_offset"]})
这段代码引入了一个简单的状态管理机制。通过维护一个 JSON 状态文件,应用可以追踪每个分片上传的进度。虽然这不适合高并发场景,但对于理解分片上传的状态管理逻辑非常直观。在实际生产中,建议使用 Redis 等内存数据库来替代文件系统状态存储,以提高性能和可靠性。
如何验证所有分片上传完成并合并文件
分片上传的最后一步是确认所有分片都已到达并完成合并。这通常由客户端在完成所有分片上传后发送一个特定的请求(如 POST /complete)来触发。服务器端需要检查状态文件中记录的 received_offset 是否等于预期的总大小。如果相等,则可以将临时文件重命名为最终文件名,或者执行其他清理操作。如果不想依赖客户端通知,也可以定期检查状态文件,但这种方式效率较低且复杂。
@app.post("/complete")
async def complete_upload(request: Request):
    file_id = request.headers.get("X-File-ID", "default")
    state = load_state(file_id)

    expected_total = state.get("total_size", 0)
    received = state.get("received_offset", 0)

    if received == expected_total and expected_total > 0:
        src = os.path.join(UPLOAD_DIR, f"{file_id}.tmp")
        dst = os.path.join(UPLOAD_DIR, f"{file_id}.mp4") # 假设是视频文件
        if os.path.exists(src):
            os.rename(src, dst)
            # 清理状态文件
            os.remove(get_state_file(file_id))
            return JSONResponse({"status": "completed", "file_url": f"/files/{file_id}.mp4"})
        else:
            return JSONResponse({"error": "Source file missing"}, status_code=500)
    else:
        return JSONResponse({"error": "Incomplete upload", "expected": expected_total, "received": received}, status_code=400)
此代码块展示了完成上传的逻辑。它首先加载状态,然后比较已接收的字节数和预期总大小。如果匹配,就将临时文件重命名为正式文件名。这种基于状态的验证方式简单有效,确保了数据的完整性。需要注意的是,在生产环境中,应添加更多的错误处理和日志记录,以应对网络中断或服务器崩溃等异常情况。









