





本篇文章给大家带来了关于python的相关知识,其中主要介绍了关于爬虫的相关知识,爬虫简单的来说就是用程序获取网络上数据这个过程的一种名称,下面一起来看一下,希望对大家有帮助。

爬虫是什么
爬虫简单的来说就是用程序获取网络上数据这个过程的一种名称。
爬虫的原理
如果要获取网络上数据,我们要给爬虫一个网址(程序中通常叫URL),爬虫发送一个HTTP请求给目标网页的服务器,服务器返回数据给客户端(也就是我们的爬虫),爬虫再进行数据解析、保存等一系列操作。
流程
爬虫可以节省我们的时间,比如我要获取豆瓣电影 Top250 榜单,如果不用爬虫,我们要先在浏览器上输入豆瓣电影的 URL ,客户端(浏览器)通过解析查到豆瓣电影网页的服务器的 IP 地址,然后与它建立连接,浏览器再创造一个 HTTP 请求发送给豆瓣电影的服务器,服务器收到请求之后,把 Top250 榜单从数据库中提出,封装成一个 HTTP 响应,然后将响应结果返回给浏览器,浏览器显示响应内容,我们看到数据。我们的爬虫也是根据这个流程,只不过改成了代码形式。

HTTP请求
HTTP 请求由请求行、请求头、空行、请求体组成。

请求行由三部分组成:
1.请求方法,常见的请求方法有 GET、POST、PUT、DELETE、HEAD
2.客户端要获取的资源路径
3.是客户端使用的 HTTP 协议版本号
请求头是客户端向服务器发送请求的补充说明,比如说明访问者身份,这个下面会讲到。
请求体是客户端向服务器提交的数据,比如用户登录时需要提高的账号密码信息。请求头与请求体之间用空行隔开。请求体并不是所有的请求都有的,比如一般的GET都不会带有请求体。
上图就是浏览器登录豆瓣时向服务器发送的HTTP POST 请求,请求体中指定了用户名和密码。
HTTP 响应
HTTP 响应格式与请求的格式很相似,也是由响应行、响应头、空行、响应体组成。
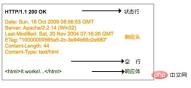
响应行也包含三部分,分别是服务端的 HTTP 版本号、响应状态码和状态说明。
这里状态码有一张表,对应了各个状态码的意思
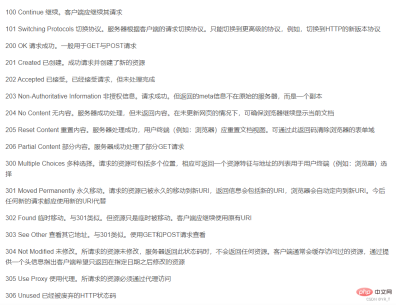
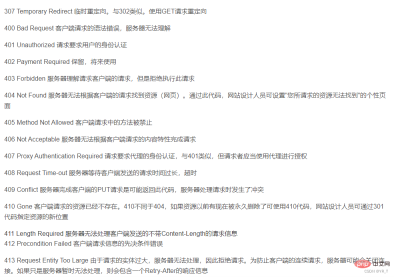
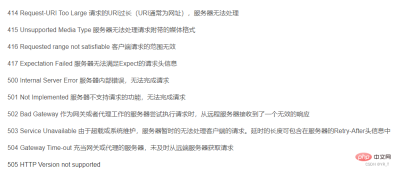
第二部分就是响应头,响应头与请求头对应,是服务器对该响应的一些附加说明,比如响应内容的格式是什么,响应内容的长度有多少、什么时间返回给客户端的、甚至还有一些 Cookie 信息也会放在响应头里面。
第三部分是响应体,它才是真正的响应数据,这些数据其实就是网页的 HTML 源代码。
爬虫代码怎么写
爬虫可以用很多语言比如 Python、C++等等,但是我觉得Python是最简单的,
因为Python有现成可用的库,已经封装到几乎完美,
C++虽然也有现成的库,但是它的爬虫还是比较小众,仅有的库也不足以算上简单,而且代码在各个编译器上,甚至同一个编译器上不同版本的兼容性不强,所以不是特别好用。所以今天主要介绍python爬虫。
安装requests库
cmd运行:pip install requests ,安装 requests。
然后在 IDLE 或者编译器(个人推荐 VS Code 或者 Pycharm )上输入
import requests 运行,如果没有报错,证明安装成功。

让 macOS 自动化像说话一样简单 —— 用代码控制你的 Mac,无需学习 AppleScript 系统要求 macOS 14+ (Sonoma) Python 3.9+ 需要开启:辅助功能 + 屏幕录制权限
安装大部分库的方法都是:pip install xxx(库的名字)
requests的方法
| requests.request() | 构造一个请求,支撑一下各方法的基本方法 |
| requests.get() | 获取HTML网页的主要方法,对应于HTTP的GET |
requests.head() |
获取HTML网页头信息的方法,对应于HTTP的HEAD |
| requests.post() | 向HTML网页提交POST请求的方法,对应于HTTP的POST |
| requests.put() | 向HTML网页提交PUT请求的方法,对应于HTTP的PUT |
| requests.patch( ) | 向HTML网页提交局部修改请求,对应于HTTP的PATCT |
| requests.delete() | 向HTML网页提交删除请求,对应于HTTP的DELETE |
最常用的get方法
r = requests.get(url)
包括两个重要的对象:
构造一个向服务器请求资源的Request对象;返回一个包含服务器资源的Response对象
| r.status_code | HTTP请求的返回状态,200表示连接成功,404表示失败 |
| r.text | HTTP响应内容的字符串形式,即,url对应的页面内容 |
| r.encoding | 从HTTP header中猜测的响应内容编码方式(如果header中不存在charset,则认为编码为ISO-8859-1) |
| r.apparent_encoding | 从内容中分析的响应内容编码方式(备选编码方式) |
| r.content | HTTP响应内容的二进制形式 |
| requests.ConnectionError | 网络连接错误异常,如DNS查询失败、拒绝连接等 |
| requests.HTTPError | HTTP错误异常 |
| requests.URLRequired | URL缺失异常 |
| requests.TooManyRedirects | 超过最大重定向次数,产生重定向异常 |
| requests.ConnectTimeout | 连接远程服务器超时异常 |
| requests.Timeout | 请求URL超时,产生超时异常 |
爬虫小demo
requests是最基础的爬虫库,但是我们可以做一个简单的翻译
我先把我做的一个爬虫的小项目的项目结构放上,完整源码可以私聊我下载。
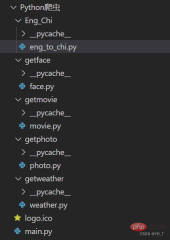
下面是翻译部分的源码
import requests
def English_Chinese():
	url = "https://fanyi.baidu.com/sug"
	s = input("请输入要翻译的词(中/英):")
	dat = {
		"kw":s
		}
	resp = requests.post(url,data = dat)# 发送post请求
	ch = resp.json() # 将服务器返回的内容直接处理成json => dict
	resp.close()
	dic_lenth = len(ch['data'])
	for i in range(dic_lenth):
		print("词:"+ch['data'][i]['k']+" "+"单词意思:"+ch['data'][i]['v'])
代码详解:
导入requests模块,设置 url为百度翻译网页的网址。
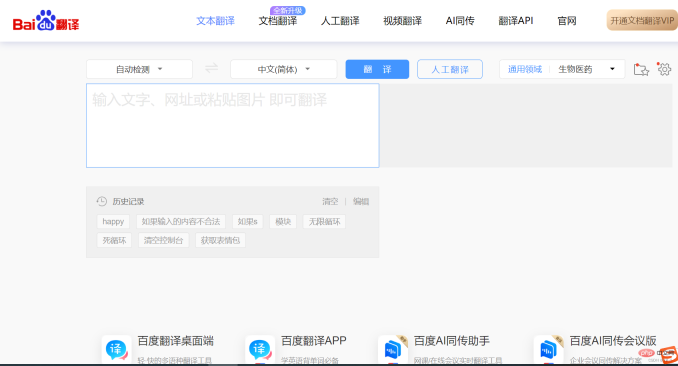
然后通过 post 方法发送请求,再把返回的结果打成一个 dic (字典),但是这个时候我们打印出来结果发现是这样的。

这是一个字典里套列表套字典的样子,大概就是这样的
{ xx:xx , xx:[ {xx:xx} , {xx:xx} , {xx:xx} , {xx:xx} ] }
我标红的地方是我们需要的信息。
假如说我标蓝色的列表里面有 n 个字典,我们可以通过 len() 函数获取 n 的数值,
并使用 for 循环遍历,得到结果。
dic_lenth = len(ch['data']
for i in range(dic_lenth):
    print("词:"+ch['data'][i]['k']+" "+"单词意思:"+ch['data'][i]['v'])
最后
好了,今天的分享就到这里了,拜拜~
哎?忘了一件事,再给你们一个爬取天气的代码!
# -*- coding:utf-8 -*-
import requests
import bs4


def get_web(url):
    header = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.114 Safari/537.36 Edg/91.0.864.59"}
    res = requests.get(url, headers=header, timeout=5)
    # print(res.encoding)
    content = res.text.encode('ISO-8859-1')
    return content


def parse_content(content):
    soup = bs4.BeautifulSoup(content, 'lxml')

    '''
    存放天气情况
    '''
    list_weather = []
    weather_list = soup.find_all('p', class_='wea')
    for i in weather_list:
        list_weather.append(i.text)

    '''
    存放日期
    '''
    list_day = []
    i = 0
    day_list = soup.find_all('h1')
    for each in day_list:
        if i  0:
            list_tem.append([each.span.text, each.i.text])
            i += 1
    # print(list_tem)

    '''
    存放风力
    '''
    list_wind = []
    wind_list = soup.find_all('p', class_='win')
    for each in wind_list:
        list_wind.append(each.i.text.strip())
    # print(list_wind)
    return list_day, list_weather, list_tem, list_wind


def get_content(url):
    content = get_web(url)
    day, weather, tem, wind = parse_content(content)
    item = 0
    for i in range(0, 7):
        if item == 0:
            print(day[i]+':\t')
            print(weather[i]+'\t')
            print("今日气温:"+tem[i]+'\t')
            print("风力:"+wind[i]+'\t')
            print('\n')
            item += 1
        elif item > 0:
            print(day[i]+':\t')
            print(weather[i] + '\t')
            print("最高气温:"+tem[i][0]+'\t')
            print("最低气温:"+tem[i][1] + '\t')
            print("风力:"+wind[i]+'\t')
            print('\n')
【相关推荐:Python3视频教程 】
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!







