前言:
什么是apache druid?
它是一个集时间序列数据库、数据仓库和全文检索系统特点于一体的分析性数据平台。
本文会为大家简单了解一下druid的特性、使用场景、技术特点和架构等,这会有助于我们选择数据存储方案,深入了解druid存储和时间序列存储等。
概览
一个现代化的云原生,流原生,分析型数据库
Druid是为快速查询和快速摄入数据的工作流而设计的。Druid强在有强大的UI,运行时可操作查询,和高性能并发处理。Druid可以被视为一个满足多样化用户场景的数据仓库的开源替代品。
轻松与现有的数据管道集成
Druid可以从消息总线流式获取数据(如Kafka,Amazon Kinesis),或从数据湖批量加载文件(如HDFS,Amazon S3和其他同类数据源)。
比传统方案快100倍的性能
Druid对数据摄入和数据查询的基准性能测试大大超过了传统解决方案。
Druid的架构融合了数据仓库,时间序列数据库和检索系统最好的特性。
解锁新的工作流
Druid为Clickstream,APM(应用性能管理系统),supply chain(供应链),网络遥测,数字营销和其他事件驱动形式的场景解锁了新的查询方式和工作流。Druid专为实时和历史数据的快速临时查询而构建。
部署在AWS/GCP/Azure,混合云,k8s和租用服务器上
Druid可以部署在任何*NIX环境中。无论是内部环境还是云环境。部署Druid是非常easy的:通过添加或删减服务来扩容缩容。
使用场景
Apache Druid适用于对实时数据提取,高性能查询和高可用要求较高的场景。因此,Druid通常被作为一个具有丰富GUI的分析系统,或者作为一个需要快速聚合的高并发API的后台。Druid更适合面向事件数据。
比较常见的使用场景:
点击流分析(web和mobile分析)
风控分析
网路遥测分析(网络性能监控)
服务器指标存储
供应链分析(制造业指标)
应用性能指标
商业智能/实时在线分析系统OLAP
下面将详细分析这些使用场景:
用户活动和行为
Druid经常用在点击流,访问流,和活动流数据上。具体场景包括:衡量用户参与度,为产品发布追踪A/B测试数据,并了解用户使用方式。Druid可以做到精确和近似计算用户指标,例如不重复计数指标。这意味着,如日活用户指标可以在一秒钟计算出近似值(平均精度98%),以查看总体趋势,或精确计算以展示给利益相关者。Druid可以用来做“漏斗分析”,去测量有多少用户做了某种操作,而没有做另一个操作。这对产品追踪用户注册十分有用。
网络流
Druid常常用来收集和分析网络流数据。Druid被用于管理以任意属性切分组合的流数据。Druid能够提取大量网络流记录,并且能够在查询时快速对数十个属性组合和排序,这有助于网络流分析。这些属性包括一些核心属性,如IP和端口号,也包括一些额外添加的强化属性,如地理位置,服务,应用,设备和ASN。Druid能够处理非固定模式,这意味着你可以添加任何你想要的属性。
数字营销
Druid常常用来存储和查询在线广告数据。这些数据通常来自广告服务商,它对衡量和理解广告活动效果,点击穿透率,转换率(消耗率)等指标至关重要。
Druid最初就是被设计成一个面向广告数据的强大的面向用户的分析型应用程序。在存储广告数据方面,Druid已经有大量生产实践,全世界有大量用户在上千台服务器上存储了PB级数据。
应用性能管理
Druid常常用于追踪应用程序生成的可运营数据。和用户活动使用场景类似,这些数据可以是关于用户怎样和应用程序交互的,它可以是应用程序自身上报的指标数据。Druid可用于下钻发现应用程序不同组件的性能如何,定位瓶颈,和发现问题。
不像许多传统解决方案,Druid具有更小存储容量,更小复杂度,更大数据吞吐的特点。它可以快速分析数以千计属性的应用事件,并计算复杂的加载,性能,利用率指标。比如,基于百分之95查询延迟的API终端。我们可以以任何临时属性组织和切分数据,如以天为时间切分数据,如以用户画像统计,如按数据中心位置统计。
物联网和设备指标
Driud可以作为时间序列数据库解决方案,来存储处理服务器和设备的指标数据。收集机器生成的实时数据,执行快速临时的分析,去估量性能,优化硬件资源,和定位问题。
和许多传统时间序列数据库不同,Druid本质上是一个分析引擎。Druid融合了时间序列数据库,列式分析数据库,和检索系统的理念。它在单个系统中支持了基于时间分区,列式存储,和搜索索引。这意味着基于时间的查询,数字聚合,和检索过滤查询都会特别快。
你可以在你的指标中包括百万唯一维度值,并随意按任何维度组合group和filter(Druid 中的 dimension维度类似于时间序列数据库中的tag)。你可以基于tag group和rank,并计算大量复杂的指标。而且你在tag上检索和过滤会比传统时间序列数据库更快。
OLAP和商业智能
Druid经常用于商业智能场景。公司部署Druid去加速查询和增强应用。和基于Hadoop的SQL引擎(如Presto或Hive)不同,Druid为高并发和亚秒级查询而设计,通过UI强化交互式数据查询。这使得Druid更适合做真实的可视化交互分析。
技术
Apache Druid 是一个开源的分布式数据存储引擎。Druid的核心设计融合了OLAP/analytic databases,timeseries database,和search systems的理念,以创造一个适用广泛用例的统一系统。Druid将这三种系统的主要特性融合进Druid的ingestion layer(数据摄入层),storage format(存储格式化层),querying layer(查询层),和core architecture(核心架构)中。
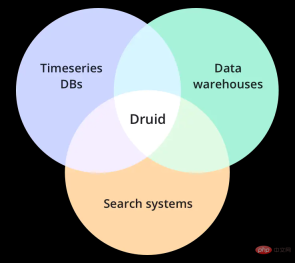
Druid的主要特性包括:

通过Apache Tika Server REST API从1400多种文件格式中提取文本和元数据。处理PDF、DOCX、PPTX、电子邮件归档以及带有MIME类型检测的嵌入式文档提取。
列式存储
Druid单独存储并压缩每一列数据。并且查询时只查询特定需要查询的数据,支持快速scan,ranking和groupBy。
原生检索索引
Druid为string值创建反向索引以达到数据的快速搜索和过滤。
流式和批量数据摄入
开箱即用的Apache kafka,HDFS,AWS S3连接器connectors,流式处理器。
灵活的数据模式
Druid优雅地适应不断变化的数据模式和嵌套数据类型。
基于时间的优化分区
Druid基于时间对数据进行智能分区。因此,Druid基于时间的查询将明显快于传统数据库。
支持SQL语句
除了原生的基于JSON的查询外,Druid还支持基于HTTP和JDBC的SQL。
水平扩展能力
百万/秒的数据摄入速率,海量数据存储,亚秒级查询。
易于运维
可以通过添加或移除Server来扩容和缩容。Druid支持自动重平衡,失效转移。
数据摄入
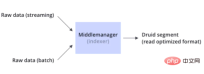
Druid同时支持流式和批量数据摄入。Druid通常通过像Kafka这样的消息总线(加载流式数据)或通过像HDFS这样的分布式文件系统(加载批量数据)来连接原始数据源。
Druid通过Indexing处理将原始数据以segment的方式存储在数据节点,segment是一种查询优化的数据结构。
数据存储
像大多数分析型数据库一样,Druid采用列式存储。根据不同列的数据类型(string,number等),Druid对其使用不同的压缩和编码方式。Druid也会针对不同的列类型构建不同类型的索引。
类似于检索系统,Druid为string列创建反向索引,以达到更快速的搜索和过滤。类似于时间序列数据库,Druid基于时间对数据进行智能分区,以达到更快的基于时间的查询。
不像大多数传统系统,Druid可以在数据摄入前对数据进行预聚合。这种预聚合操作被称之为rollup,这样就可以显著的节省存储成本。
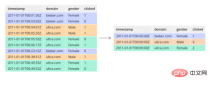
查询
Druid支持JSON-over-HTTP和SQL两种查询方式。除了标准的SQL操作外,Druid还支持大量的唯一性操作,利用Druid提供的算法套件可以快速的进行计数,排名和分位数计算。
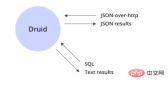
架构
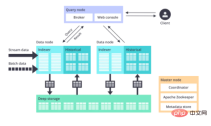
Druid是微服务架构,可以理解为一个拆解成多个服务的数据库。Druid的每一个核心服务(ingestion(摄入服务),querying(查询服务),和coordination(协调服务))都可以单独部署或联合部署在商业硬件上。
Druid清晰的命名每一个服务,以确保运维人员可以根据使用情况和负载情况很好地调整相应服务的参数。例如,当负载需要时,运维人员可以给数据摄入服务更多的资源而减少数据查询服务的资源。
Druid可以独立失败而不影响其他服务的运行。
运维
Drui被设计成一个健壮的系统,它需要7*24小时运行。Druid拥有以下特性,以确保长期运行,并保证数据不丢失。
数据副本
Druid根据配置的副本数创建多个数据副本,所以单机失效不会影响Druid的查询。
独立服务
Druid清晰的命名每一个主服务,每一个服务都可以根据使用情况做相应的调整。服务可以独立失败而不影响其他服务的正常运行。例如,如果数据摄入服务失效了,将没有新的数据被加载进系统,但是已经存在的数据依然可以被查询。
自动数据备份
Druid自动备份所有已经indexed的数据到一个文件系统,它可以是分布式文件系统,如HDFS。你可以丢失所有Druid集群的数据,并快速从备份数据中重新加载。
滚动更新
通过滚动更新,你可以在不停机的情况下更新Druid集群,这样对用户就是无感知的。所有Druid版本都是向后兼容。
想了解时间序列数据库和对比,可移步另一篇文章:
相关推荐:apache服务器