介绍python60行代码写一个简单的笔趣阁爬虫

陌萱吖_9777

陌萱吖_9777

2021-01-13

3226人浏览

转载

推荐(免费):Python视频教程

文章目录

  • 系列文章目录
  • 前言
  • 一、网页解析
  • 二、代码填写
    • 1.获取Html及写入方法
    • 2.其余代码
  • 总结

前言

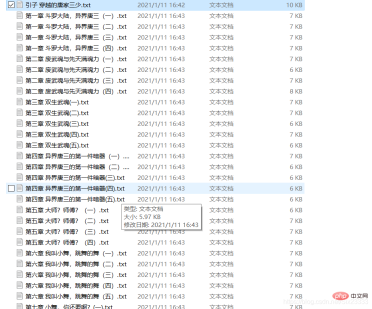
利用python写一个简单的笔趣阁爬虫,根据输入的小说网址爬取整个小说并保存到txt文件。爬虫用到了BeautifulSoup库的select方法
结果如图所示:
在这里插入图片描述
本文只用于学习爬虫


一、网页解析

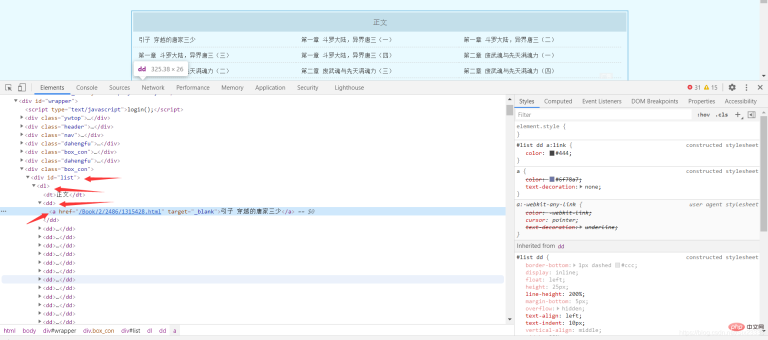
这里以斗罗大陆小说为例 网址:
http://www.biquge001.com/Book/2/2486/
在这里插入图片描述
可以发现每章的网页地址和章节名都放在了 中的a标签中,所以利用BeautfulSoup中的select方法可以得到网址和章节名

Tag = BeautifulSoup(getHtmlText(url), "html.parser") #这里的getHtmlText是自己写的获取html的方法urls = Tag.select("p #list dl dd a")

然后遍历列表

for url in urls:
    href = "http://www.biquge001.com/" + url['href']  # 字符串的拼接 拼接成正确的网址
    pageName = url.text  # 每章的章名

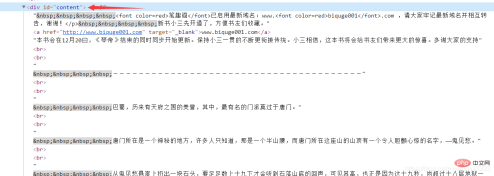
然后每章小说的内容都存放在
在这里插入图片描述

  substance = Tag.select("p #content")  # 文章的内容

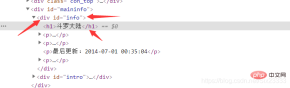
最后同理在首页获取小说的名称
在这里插入图片描述

bookName = Tag.select("p #info h1")

二、代码填写

1.获取Html及写入方法

def getHtmlText(url):
    r = requests.get(url, headers=headers)
    r.encoding = r.apparent_encoding  # 编码转换
    r.raise_for_status()
    return r.textdef writeIntoTxt(filename, content):
    with open(filename, "w", encoding="utf-8") as f:
        f.write(content)
        f.close()
        print(filename + "已完成")

2.其余代码

代码如下(示例):

url = "http://www.biquge001.com/Book/2/2486/"substanceStr = ""bookName1 = ""html = getHtmlText(url)# 判断是否存在这个文件Tag = BeautifulSoup(getHtmlText(url), "html.parser")urls = Tag.select("p #list dl dd a")bookName = Tag.select("p #info h1")for i in bookName:
    bookName1 = i.textif not os.path.exists(bookName1):
    os.mkdir(bookName1)
    print(bookName1 + "创建完成")else:
    print("文件已创建")for url in urls:
    href = "http://www.biquge001.com/" + url['href']  # 字符串的拼接 拼接成正确的网址
    pageName = url.text  # 每章的章名
    path = bookName1 + "\"  # 路径
    fileName = path + url.text + ".txt"  # 文件名 = 路径 + 章节名 + ".txt"
    Tag = BeautifulSoup(getHtmlText(href), "html.parser")  # 解析每张的网页
    substance = Tag.select("p #content")  # 文章的内容
    for i in substance:
        substanceStr = i.text
    writeIntoTxt(fileName, substanceStr)
    time.sleep(1)


总结

简单利用了BeautfulSoup的select方法对笔趣阁的网页进行了爬取           

更多相关学习敬请关注Python教程栏目!

Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!

python速学教程(入门到精通)
python速学教程(入门到精通)

python怎么学习?python怎么入门?python在哪学?python怎么学才快?不用担心,这里为大家提供了python速学教程(入门到精通),有需要的小伙伴保存下载就能学习啦!

下载

相关标签:

本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系admin@php.cn

相关专题

更多
Python爬虫获取数据的方法
Python爬虫获取数据的方法

Python爬虫可以通过请求库发送HTTP请求、解析库解析HTML、正则表达式提取数据,或使用数据抓取框架来获取数据。更多关于Python爬虫相关知识。详情阅读本专题下面的文章。php中文网欢迎大家前来学习。

2023.11.13

713

12

http500解决方法
http500解决方法

http500解决方法有检查服务器日志、检查代码错误、检查服务器配置、检查文件和目录权限、检查资源不足、更新软件版本、重启服务器或寻求专业帮助等。本专题为大家提供相关的文章、下载、课程内容,供大家免费下载体验。

2023.11.09

4203

4

http请求415错误怎么解决
http请求415错误怎么解决

解决方法:1、检查请求头中的Content-Type;2、检查请求体中的数据格式;3、使用适当的编码格式;4、使用适当的请求方法;5、检查服务器端的支持情况。更多http请求415错误怎么解决的相关内容,可以阅读下面的文章。

2023.11.14

1014

3

HTTP 503错误解决方法
HTTP 503错误解决方法

HTTP 503错误表示服务器暂时无法处理请求。想了解更多http错误代码的相关内容,可以阅读本专题下面的文章。

2024.03.12

6986

8

http与https有哪些区别
http与https有哪些区别

http与https的区别:1、协议安全性;2、连接方式;3、证书管理;4、连接状态;5、端口号;6、资源消耗;7、兼容性。本专题为大家提供相关的文章、下载、课程内容,供大家免费下载体验。

2024.08.16

5650

6

Go 语言 HTTP 编程与中间件开发教程合集

全面讲解 Go 语言 HTTP 编程的核心知识,涵盖 net/http 标准库的 Server/Handler/HandlerFunc 体系、DefaultServeMux 路由注册与自定义路由器、Request / ResponseWriter 请求响应处理、中间件(Middleware)链式设计模式与常见中间件(日志/CORS/认证/限流)开发、http.Client 的超时配置与连接池管理、Cookie / Session 处理、

2026.05.08

641

31

GoFrame框架Web开发与路由中间件

本专题聚焦GoFrame框架的Web开发,拆解路由注册与匹配规则、请求参数获取、参数校验与中间件执行顺序,说明统一响应、JWT鉴权、文件上传与接口文档生成的落地方式,并补充优雅重启与测试实践。

2026.11.17

20

15

GoFrame框架安装与gf命令行工具
GoFrame框架安装与gf命令行工具

本专题围绕GoFrame框架的安装与工具链配置展开,讲清Go版本要求、gf命令行的安装方式、代理镜像与依赖准备,说明项目初始化、热编译、交叉编译打包的做法,并整理安装阶段的常见报错与验证步骤。

2026.11.17

20

15

GoFrame框架零基础入门
GoFrame框架零基础入门

本专题整理GoFrame框架的入门知识,从模块化设计理念、环境准备到跑通第一个Web服务,讲清目录分层、配置加载、日志与中间件的用法,并对比Gin、Go-Zero的差异,帮助Go开发者建立整体认知。

2026.11.17

20

15

热门下载

更多
网站特效
/
网站源码
/
网站素材
/
前端模板

精品课程

更多
热门推荐
/
最新课程
phpStudy极速入门视频教程
phpStudy极速入门视频教程

共6课时 | 54.7万人学习

独孤九贱(4)_PHP视频教程
独孤九贱(4)_PHP视频教程

共89课时 | 134.3万人学习