今天编写python爬虫,突然爬取的网页异常,并报错:unicodeencodeerror: 'latin-1' codec can't encode characters in position 41-50: ordinal not in range(256);unicodeencodeerror: 'ascii' codec can't encode characters in ordinal,这是明显的编码格式的问题。其实不仅是python2或者3,还是其他java,c等编程语言,经常会遇到编码格式的问题,异常头痛,尤其是ascii、gbk、utf-8等编码之间的转换。于是查找资料、动手实践,找到这样的几个方法。
首先关于python的系统编码格式和输入输出格式,我们如何查看呢?
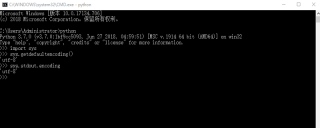
>>> import sys
>>> sys.getdefaultencoding()# 系统默认编码格式
'UTF-8'
>>> sys.stdout.encoding# 输入输出格式
'US-ASCII'
这种情况下表示,当前的命令行的输入输出编码是ascii,所以需要手动改成设置环境变量LANG为utf-8:
export LANG="en_US.UTF-8"
如果是在ubuntu环境下,可以将上面这行命令加入~/.bashrc中一劳永逸解决问题,加入后运行下面命令使其生效或者重启生效。
source ~/.bashrc
或者另一种方法是,只针对python设定相应编码(同上,命令行运行或者加入bashrc文件):
PYTHONIOENCODING='utf_8'
export PYTHONIOENCODING
gbk编码示例图:
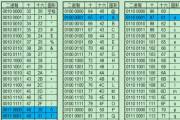
ascii编码表图部分:
在平时代码编程时别忘了给顶行加上:
# -*- coding: utf-8 -*-
设置python编码可以使用命令行,但是仅在本会话中生效
>>>sys.getdefaultencoding()查看当前编码(若报错,先执行>>>import sys >>>reload(sys));
>>>sys.setdefaultencoding('utf8')设置编码
在程序代码中重新载入SYS模块并设置uft-8也是可行的,但是在pycharm中会提示错误

Python 环境工具专业版功能概述Python 环境工具专业版是一项面向实际任务的技能。它将相关步骤、工具调用和结果整理方式集中到统一流程中,帮助使用者更快完成目标并减少重复操作。核心要点使用时应结合输入条件选择合适的执行方式,核对必要参数、依赖环境与输出内容,并按原始要求处理异常情况。该技能适合需要稳定复用相关能力的场景,可作为自动化工作流的一部分,也便于后续检查、调整和扩展。执行完成后建议检查结果是否符合预期,并保留必要记录。使用与执行同时注意输入完整性、执行条件和输出可用性。从功能定位来看,该技能
import sys
reload(sys)
sys.setdefaultencoding('utf8')
重启Python解释器,发现编码已被设置为utf8;
这是因为系统在Python启动的时候,自行调用该文件,设置系统的默认编码,而不需要每次都手动加上解决代码,属于一劳永逸的解决方法。
在平时开发时,我们都知道利用Decode和Encode进行转码操作。
Decode的作用是将其他编码的字符串转换成unicode编码,如str1.decode('gb2312'),表示将gb2312编码的字符串str1转换成unicode编码。
Encode的作用是将unicode编码转换成其他编码的字符串,如str2.encode('gb2312'),表示将unicode编码的字符串str2转换成gb2312编码。
在最新的python 3版本中,字符串的类型是str, 在内存中都是以Unicode表示,一个字符对应若干个字节;
如果要在网络上传输,或者保存到磁盘上,就需要把str变为以字节为单位的bytes。
以Unicode表示的str通过encode()方法可以编码为指定的bytes,例如:
>>> 'ABC'.encode('ascii')
b'ABC'
>>> '中文'.encode('utf-8')
b'\xe4\xb8\xad\xe6\x96\x87'
>>> '中文'.encode('ascii')
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
UnicodeEncodeError: 'ascii' codec can't encode characters in position 0-1: ordinal not in range(128)</module></stdin>
在操作字符串时,我们经常遇到str和bytes的互相转换。为了避免乱码问题,应当始终坚持使用UTF-8编码对str和bytes进行转换。
友情链接【UTF-8编码转换工具】
编码格式最初只有几种,由于计算机的普及,许多国家或组织的使用,编码格式也变得越来越多,但是国际通用的依然是UTF-8,所以应该有个良好的编程习惯,多使用UTF-8编码格式。在遇到编码问题时,也尽量保持编码格式的统一。
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!