






稍微了解dede采集规则的朋友上篇内容完全可以略过,下面看看如何以静制动、以不变就万变地解决分页采集问题。
二、采集新目标
目标地址:
1、http://www.tiansou.net/html/y_cyfw/r_gzzj/f_gzjh/index.html
2、http://www.tiansou.net/html/y_cyfw/r_gzzj/f_gzjh/2007-2/9/20070209110903558.html
之所以选取两个目标页面,是因为以上的两个页面一个有分页,而另一个没有,并且在分页和全文取样部分有较大的差别。以下的说明是在为采集目标地址(首页)全部链接的基础上改动的,个别地方会显得蛇足,只为说明的方便。
目标文字部分头部代码1: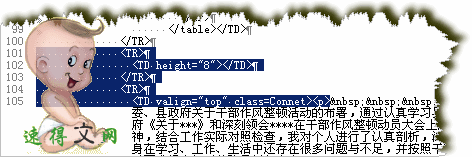
目标文字部分头部代码2: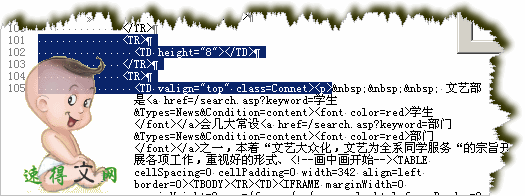
通过比较不难发现,两个文字部分的开始采集部分能确定下来为描黑部分,开头部分好说,代码如下:
复制代码 代码如下:
目标文尾及分页区域代码1: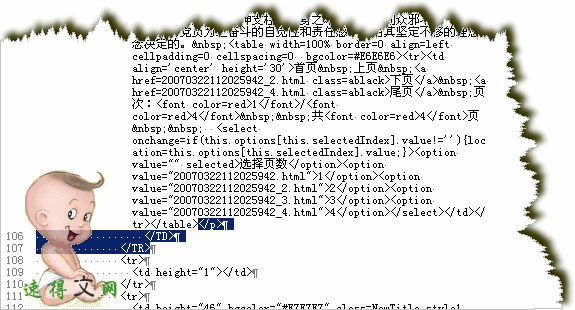
目标文尾及分页区域代码2: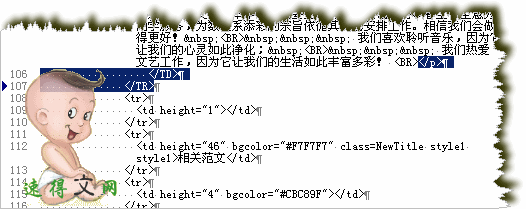
比较一下两个结尾,尽管想把第一个的结尾再往前提一点,但没法子,要考虑到全部链接的共同部分,就只好取描黑的部分了,这也给今后确定过滤规则添了点麻烦,这是后话。先把结尾部分确定了吧:
复制代码 代码如下:
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!








