






抓取四川大学公共管理学院官网()所有的新闻咨询.
实验流程
1.确定抓取目标.
2.制定抓取规则.
3.'编写/调试'抓取规则.
4.获得抓取数据
1.确定抓取目标
我们这次需要抓取的目标为四川大学公共管理学院的所有新闻资讯.于是我们需要知道公管学院官网的布局结构.
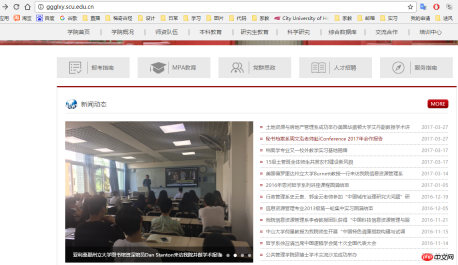
这里我们发现想要抓到全部的新闻信息,不能直接在官网首页进行抓取,需要点击"more"进入到新闻总栏目里面.
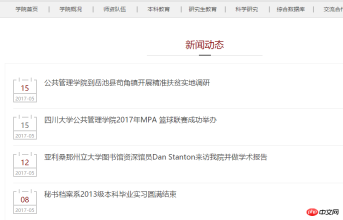
我们看到了具体的新闻栏目,但是这显然不满足我们的抓取需求: 当前新闻动态网页只能抓取新闻的时间,标题和URL,但是并不能抓取新闻的内容.所以我们想要需要进入到新闻详情页抓取新闻的具体内容.
2.制定抓取规则
通过第一部分的分析,我们会想到,如果我们要抓取一篇新闻的具体信息,需要从新闻动态页面点击进入新闻详情页抓取到新闻的具体内容.我们点击一篇新闻尝试一下
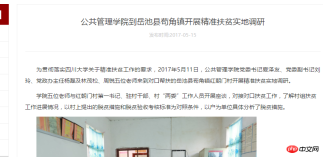
我们发现,我们能够直接在新闻详情页面抓取到我们需要的数据:标题,时间,内容.URL.
好,到现在我们清楚抓取一篇新闻的思路了.但是,如何抓取所有的新闻内容呢?
这显然难不到我们.
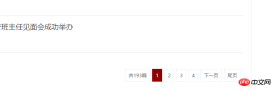
我们在新闻栏目的最下方能够看到页面跳转的按钮.那么我们可以通过"下一页"按钮实现抓取所有的新闻.
那么整理一下思路,我们能够想到一个显而易见的抓取规则:
通过抓取'新闻栏目下'所有的新闻链接,并且进入到新闻详情链接里面抓取所有的新闻内容.
3.'编写/调试'抓取规则
为了让调试爬虫的粒度尽量的小,我将编写和调试模块糅合在一起进行.
在爬虫中,我将实现以下几个功能点:
1.爬出一页新闻栏目下的所有新闻链接2.通过爬到的一页新闻链接进入到新闻详情爬取所需要数据(主要是新闻内容)3.通过循环爬取到所有的新闻.
分别对应的知识点为:
1.爬出一个页面下的基础数据.
2.通过爬到的数据进行二次爬取.
3.通过循环对网页进行所有数据的爬取.
话不多说,现在开干.
3.1爬出一页新闻栏目下的所有新闻链接
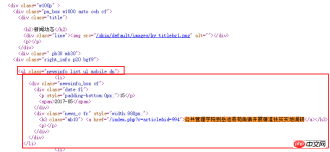
通过对新闻栏目的源代码分析,我们发现所抓数据的结构为

那么我们只需要将爬虫的选择器定位到(li:newsinfo_box_cf),再进行for循环抓取即可.
编写代码
import scrapyclass News2Spider(scrapy.Spider):
    name = "news_info_2"
    start_urls = ["http://ggglxy.scu.edu.cn/index.php?c=special&sid=1&page=1",
    ]def parse(self, response):for href in response.xpath("//div[@class='newsinfo_box cf']"):
            url = response.urljoin(href.xpath("div[@class='news_c fr']/h3/a/@href").extract_first())
测试,通过!
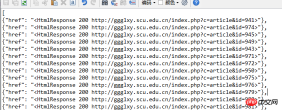
3.2通过爬到的一页新闻链接进入到新闻详情爬取所需要数据(主要是新闻内容)
现在我获得了一组URL,现在我需要进入到每一个URL中抓取我所需要的标题,时间和内容,代码实现也挺简单,只需要在原有代码抓到一个URL时进入该URL并且抓取相应的数据即可.所以,我只需要再写一个进入新闻详情页的抓取方法,并且使用scapy.request调用即可.
编写代码
#进入新闻详情页的抓取方法
def parse_dir_contents(self, response):item = GgglxyItem()item['date'] = response.xpath("//div[@class='detail_zy_title']/p/text()").extract_first()item['href'] = responseitem['title'] = response.xpath("//div[@class='detail_zy_title']/h1/text()").extract_first()
        data = response.xpath("//div[@class='detail_zy_c pb30 mb30']")item['content'] = data[0].xpath('string(.)').extract()[0]
        yield item
整合进原有代码后,有:
import scrapyfrom ggglxy.items import GgglxyItemclass News2Spider(scrapy.Spider):
    name = "news_info_2"
    start_urls = ["http://ggglxy.scu.edu.cn/index.php?c=special&sid=1&page=1",
    ]def parse(self, response):for href in response.xpath("//div[@class='newsinfo_box cf']"):
            url = response.urljoin(href.xpath("div[@class='news_c fr']/h3/a/@href").extract_first())#调用新闻抓取方法yield scrapy.Request(url, callback=self.parse_dir_contents)#进入新闻详情页的抓取方法                def parse_dir_contents(self, response):
            item = GgglxyItem()
            item['date'] = response.xpath("//div[@class='detail_zy_title']/p/text()").extract_first()
            item['href'] = response
            item['title'] = response.xpath("//div[@class='detail_zy_title']/h1/text()").extract_first()
            data = response.xpath("//div[@class='detail_zy_c pb30 mb30']")
            item['content'] = data[0].xpath('string(.)').extract()[0]yield item
测试,通过!
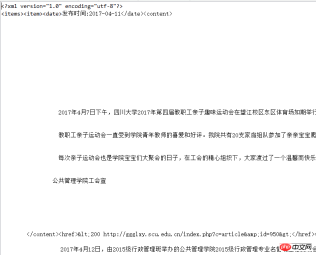
这时我们加一个循环:
NEXT_PAGE_NUM = 1

NEXT_PAGE_NUM = NEXT_PAGE_NUM + 1if NEXT_PAGE_NUM<p>加入到原本代码:</p><pre class="hljs python">import scrapyfrom ggglxy.items import GgglxyItem

NEXT_PAGE_NUM = 1class News2Spider(scrapy.Spider):
    name = "news_info_2"
    start_urls = ["http://ggglxy.scu.edu.cn/index.php?c=special&sid=1&page=1",
    ]def parse(self, response):for href in response.xpath("//div[@class='newsinfo_box cf']"):
            URL = response.urljoin(href.xpath("div[@class='news_c fr']/h3/a/@href").extract_first())yield scrapy.Request(URL, callback=self.parse_dir_contents)global NEXT_PAGE_NUM
        NEXT_PAGE_NUM = NEXT_PAGE_NUM + 1if NEXT_PAGE_NUM<p>测试:</p><div class="image-package">
<img src="https://img.php.cn/upload/article/000/000/001/e3fcc660c118308f94c219f06a2aac51-8.png?x-oss-process=image/resize,p_40" alt=""><br><div class="image-caption">Paste_Image.png</div>
</div><p>抓到的数量为191,但是我们看官网发现有193条新闻,少了两条.<br>为啥呢?我们注意到log的error有两条:<br>定位问题:原来发现,学院的新闻栏目还有两条隐藏的二级栏目:<br>比如:</p><div class="image-package">
<img src="https://img.php.cn/upload/article/000/000/001/e3fcc660c118308f94c219f06a2aac51-9.png?x-oss-process=image/resize,p_40" alt=""><br><div class="image-caption">Paste_Image.png</div>
</div><p><br>对应的URL为</p><div class="image-package">
<img src="https://img.php.cn/upload/article/000/000/001/3f4882baa987a1621aebad86efa6f72b-10.png?x-oss-process=image/resize,p_40" alt=""><br><div class="image-caption">Paste_Image.png</div>
</div><p><br>URL都长的不一样,难怪抓不到了!<br>那么我们还得为这两条二级栏目的URL设定专门的规则,只需要加入判断是否为二级栏目:</p><pre class="hljs arduino">  if URL.find('type') != -1:      yield scrapy.Request(URL, callback=self.parse)
组装原函数:
import scrapy
from ggglxy.items import GgglxyItem

NEXT_PAGE_NUM = 1class News2Spider(scrapy.Spider):
    name = "news_info_2"
    start_urls = ["http://ggglxy.scu.edu.cn/index.php?c=special&sid=1&page=1",
    ]def parse(self, response):for href in response.xpath("//div[@class='newsinfo_box cf']"):
            URL = response.urljoin(href.xpath("div[@class='news_c fr']/h3/a/@href").extract_first())if URL.find('type') != -1:yield scrapy.Request(URL, callback=self.parse)yield scrapy.Request(URL, callback=self.parse_dir_contents)
        global NEXT_PAGE_NUM
        NEXT_PAGE_NUM = NEXT_PAGE_NUM + 1if NEXT_PAGE_NUM<p>测试:</p><div class="image-package">
<img src="https://img.php.cn/upload/article/000/000/001/3f4882baa987a1621aebad86efa6f72b-11.png?x-oss-process=image/resize,p_40" alt=""><br><div class="image-caption">Paste_Image.png</div>
</div><p>我们发现,抓取的数据由以前的193条增加到了238条,log里面也没有error了,说明我们的抓取规则OK!</p><h2>4.获得抓取数据</h2><pre class="hljs haxe">     scrapy crawl news_info_2 -o 0016.json













