






php 8.6可以用spatie/robots-txt解析本地保存的robots.txt,为指定爬虫判断某条路径是否允许抓取。先传入明确的user-agent,再分别核对路径规则;robots规则属于抓取约定,不能用来保护后台或代替服务器鉴权。
官方文档:Installation
安装并使用本地规则快照
安装spatie/robots-txt:^2.6。该版本要求PHP 8.4.1以上;在PHP 8.6运行前仍需检查依赖和回归。下例只读当前项目的public/robots.txt,不会请求远端站点,也不读取页面meta或HTTP头。
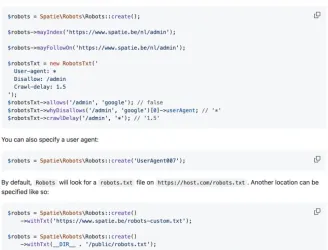
官方文档:本地RobotsTxt规则与User-Agent示例
按爬虫名判断各条路径
<?php require __DIR__ . '/vendor/autoload.php';
use Spatie\Robots\RobotsTxt;
$text = file_get_contents(__DIR__ . '/public/robots.txt');
if ($text === false) { throw new RuntimeException('Cannot read robots.txt'); }
$rules = new RobotsTxt($text);
foreach (['/', '/articles/42', '/admin/'] as $path) {
    echo json_encode([
        'path' => $path,
        'allowed' => $rules->allows($path, 'ExampleCrawler'),
    ], JSON_THROW_ON_ERROR), "\n";
}
用对照样例检查,而不是只看一个布尔值
准备包含User-agent: *、Disallow: /admin/和显式允许路径的测试文件,分别核对普通路径与受限路径。URL应先解析成你要检查的路径,不把另一个主机的地址套用这份规则。页面noindex、nofollow和响应头有独立含义;本地robots.txt允许抓取,不代表页面允许索引,也不代表其他爬虫会遵守约定。

Build MCP servers and clients for PHP applications with the official PHP SDK
下载
使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!






