






php 8.6读取已有pdf中的文字,可以使用smalot/pdfparser解析文档并逐页调用gettext()。对有文本层的pdf,这比先转图片再ocr更直接;扫描件、受保护pdf或复杂字体编码可能无法得到可用文字,不能把空结果直接当成文档没有内容。
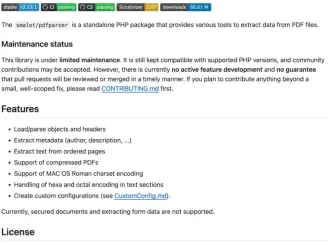
官方文档:Features
安装并限制输入
composer require smalot/pdfparser:^2.13
composer check-platform-reqs
仅处理受控本地路径。上传文件应先限制大小,解析进程还需设置memory_limit和运行超时;文件压缩后的体积小,不代表解压后也小。
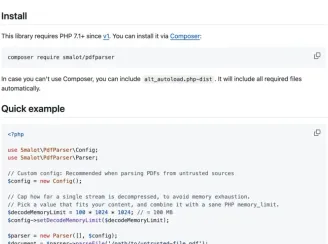
官方文档:Quick example
设置解压限制并逐页输出
<?php require __DIR__ . '/vendor/autoload.php';
use Smalot\PdfParser\Config;
use Smalot\PdfParser\Parser;
$file = __DIR__ . '/input.pdf';
if (!is_file($file) || filesize($file) > 20 * 1024 * 1024) {
    throw new RuntimeException('PDF不存在或超过输入限制');
}
$config = new Config();
$config->setDecodeMemoryLimit(64 * 1024 * 1024);
$document = (new Parser([], $config))->parseFile($file);
foreach ($document->getPages() as $index => $page) {
    echo json_encode([
        'page' => $index + 1,
        'text' => $page->getText(),
    ], JSON_UNESCAPED_UNICODE | JSON_THROW_ON_ERROR), PHP_EOL;
}
setDecodeMemoryLimit()限制单个流的解压处理,不能代替整个PHP进程的内存上限。逐页输出避免再拼接一份完整文本,但解析器本身仍会持有文档结构。
核对文本顺序与不支持的内容
使用包含中文、分栏和不同字体的代表性PDF检查抽取结果。文本在PDF中的存储顺序不一定等于屏幕阅读顺序,尤其表格和多栏排版,需要结合业务规则整理。

Build MCP servers and clients for PHP applications with the official PHP SDK
下载
使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
该库说明受保护文档和表单数据抽取不在支持范围。扫描件可转入单独的OCR流程;涉及发票金额、合同条款等字段时,还应保留页码并安排结果核对,不把提取文字直接当成已验证结构化数据。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!






