






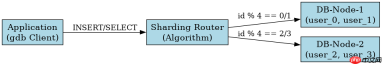
goframe 框架实现分库分表主要依赖 gdb 组件的 sharding 配置,通过定义分片规则(如取模、范围)自动将数据路由到不同的物理节点。开发者只需在配置文件中声明逻辑表与物理表的映射关系及分片算法,业务代码中继续使用标准 crud 接口即可,无需手动拼接 sql 或切换连接池。
如何配置基础的分库分表规则
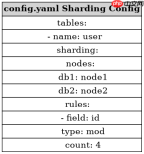
配置分库分表的核心在于修改 config.yaml 中的 databases 部分,为逻辑表添加 sharding 字段。你需要指定分片键(通常是主键或时间戳),并选择一种分片策略,例如 mod(取模)或 range(范围)。GoFrame 会自动根据这些规则计算目标数据库和表名,从而完成数据的水平拆分。
package main

import (
	"context"
	"github.com/gogf/gf/v2/frame/g"
	"github.com/gogf/gf/v2/os/gctx"
)

type User struct {
	Id     int64  `json:"id"`
	Name   string `json:"name"`
	Status int    `json:"status"`
}

func main() {
	ctx := gctx.GetInitCtx()
	// 假设 gdb 已按 config.yaml 配置好 sharding
	// 插入数据时,gf 会根据 id 自动路由到对应的 db/table
	_, err := g.Model("user").Data(User{Id: 1001, Name: "Alice", Status: 1}).Insert(ctx)
	if err != nil {
		g.Log().Error(ctx, err)
		return
	}
	// 查询时同样支持自动路由
	var user User
	err = g.Model("user").Where("id", 1001).Scan(&user)
	if err != nil {
		g.Log().Error(ctx, err)
		return
	}
	g.Log().Info(ctx, user)
}
如何处理跨分片的聚合查询
当需要执行涉及多个分片的聚合操作(如 COUNT、SUM 或 JOIN)时,GoFrame 的 gdb 提供了 UnionAll 或分布式事务支持,但更常见的做法是在应用层进行合并。对于简单的统计,可以使用 gdb 的 GroupBy 配合分片键,或者利用 GoFrame 提供的 garray 在内存中汇总各分片返回的结果。需要注意的是,跨分片的 ORDER BY 和 LIMIT 通常需要在获取全量数据后在内存中处理,或者使用专门的搜索引擎辅助。


package main

import (
	"context"
	"github.com/gogf/gf/v2/frame/g"
	"github.com/gogf/gf/v2/os/gctx"
	"sort"
)

func main() {
	ctx := gctx.GetInitCtx()
	// 示例:查询所有状态为 1 的用户,并按 ID 排序
	// 由于分片,数据分布在多个表中,直接 ORDER BY 可能不准确
	// 这里演示获取所有符合条件的用户并在内存排序
	var users []User
	err := g.Model("user").Where("status", 1).Scan(&users)
	if err != nil {
		g.Log().Error(ctx, err)
		return
	}
	// 内存排序
	sort.Slice(users, func(i, j int) bool {
		return users[i].Id <h2>基于分片键冲突时的数据迁移策略</h2><p>如果在运行过程中发现原有的分片键(如 <code>id % 10</code>)导致数据倾斜或扩容困难,GoFrame 本身不直接提供在线重哈希工具,但可以通过双写机制平滑迁移。具体做法是:新建一套分片规则,旧数据保持原样,新数据写入新规则下的表。通过后台任务扫描旧表未迁移的数据,分批写入新表,并更新元数据标记。此过程需保证读写一致性,通常结合消息队列或 Binlog 同步来实现最终一致性。</p>












