






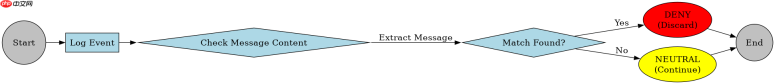
使用日志过滤器拦截敏感信息的核心做法是自定义实现 filter 接口,并在配置文件中将其注册到日志框架中。以 logback 为例,你需要创建一个继承自 ch.qos.logback.classic.filter.abstractmatcherfilter 的类,重写 decide 方法,在方法内部通过正则表达式匹配日志事件中的消息内容,一旦发现包含手机号、身份证等敏感数据的模式,就返回 deny 状态来丢弃该条日志,否则返回 neutral 放行。这样可以在日志落盘前自动完成脱敏或过滤,无需修改业务代码。
如何配置 Filter 生效并处理匹配逻辑
要让自定义的过滤器真正起作用,必须在 logback.xml 配置文件中声明该 Bean,并将其引用到 Appender 或 Logger 中。关键在于理解 Filter 的三种返回状态:DENY 表示立即停止处理并丢弃日志;ACCEPT 表示立即接受并结束过滤链;NEUTRAL 表示继续传递给下一个过滤器。通常我们使用 NEUTRAL 来保持过滤链的连续性,只有在命中敏感规则时才返回 DENY。此外,需要确保过滤器的优先级顺序正确,避免被其他过滤器提前拦截或放行。
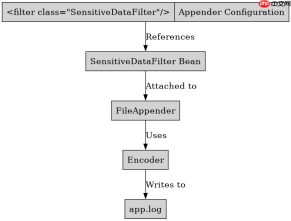
<configuration><appender name="FILE" class="ch.qos.logback.core.FileAppender"><file>app.log</file><filter class="com.example.sensitive.SensitiveDataFilter"></filter><encoder><pattern>%d{HH:mm:ss.SSS} [%thread] %-5level %logger{36} - %msg%n</pattern></encoder></appender><root level="INFO"><appender-ref ref="FILE"></appender-ref></root></configuration>
上述配置展示了如何将 SensitiveDataFilter 绑定到 FILE 输出源。当日志事件流经此 Appender 时,会先经过过滤器检查。如果日志内容如 User login: 13800138000 被判定为敏感,该条日志将不会写入文件。开发者需注意,过滤器是在日志格式化之前还是之后执行取决于具体实现,通常在 doFilter 中访问的是原始日志事件对象,因此建议基于 ILoggingEvent.getMessage() 进行正则匹配,以确保准确性。
如何处理多条件组合与性能优化
在实际项目中,敏感信息可能来自不同字段或不同场景,单一的正则匹配可能不够灵活。此时可以结合多个过滤器或使用更复杂的逻辑判断。例如,对于 JSON 格式的日志,可能需要解析 JSON 后再对特定 Key 的值进行脱敏。为了提升性能,应避免在 decide 方法中进行耗时的 I/O 操作或复杂的对象创建。可以将编译好的正则表达式缓存为静态常量,减少重复编译开销。同时,合理设置过滤器的启用/禁用状态,允许在生产环境中动态调整敏感度,而不必重启应用。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。

import ch.qos.logback.classic.filter.ThresholdFilter;
import ch.qos.logback.core.filter.Filter;
import ch.qos.logback.core.spi.FilterReply;
import java.util.regex.Pattern;

public class SensitiveDataFilter extends Filter<ch.qos.logback.classic.spi.iloggingevent> {
    private static final Pattern PHONE_PATTERN = Pattern.compile("\b1[3-9]\d{9}\b");
    private static final Pattern ID_CARD_PATTERN = Pattern.compile("\d{17}[\dXx]");

    @Override
    public FilterReply decide(ch.qos.logback.classic.spi.ILoggingEvent event) {
        String message = event.getMessage();
        if (message == null) {
            return FilterReply.NEUTRAL;
        }
        if (PHONE_PATTERN.matcher(message).find() || ID_CARD_PATTERN.matcher(message).find()) {
            return FilterReply.DENY;
        }
        return FilterReply.NEUTRAL;
    }
}</ch.qos.logback.classic.spi.iloggingevent>
这段代码展示了具体的过滤器实现。它定义了两个静态正则模式分别用于匹配手机号和身份证号。在 decide 方法中,首先获取日志消息,然后依次进行匹配。如果任一模式匹配成功,则返回 DENY 丢弃日志。这种实现方式简单高效,适用于大多数文本型日志。对于更复杂的结构,如嵌套 JSON,可以考虑引入 Jackson 库进行解析,但需注意由此带来的性能损耗。建议在测试环境中充分验证过滤效果,确保不会误删重要调试信息。
当日志中包含非标准格式数据时会发生什么
如果日志消息中包含非标准格式的数据,例如乱码、特殊字符或未转义的引号,正则表达式可能会失效或抛出异常。在这种情况下,过滤器应增加异常捕获机制,避免因解析错误导致整个日志系统崩溃。此外,对于某些加密或编码后的敏感信息(如 Base64),直接匹配明文正则无效,需先解码再匹配。开发者应明确:过滤器仅能处理其规则覆盖范围内的数据,无法智能识别所有潜在敏感信息。因此,建议定期审查和更新正则规则,并结合代码扫描工具从源头防止敏感数据进入日志流。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


