






在oracle sql中调优带有distinct的子查询,核心策略是将去重逻辑转化为集合操作(如in、exists)或聚合连接(join),以利用索引和哈希算法消除排序开销。具体做法是检查子查询是否仅用于存在性判断,若是则改用exists;若需返回列值,则通过主键关联避免笛卡尔积。这样做通常能将全表扫描转为索引范围扫描,显著降低cpu和i/o消耗。若原查询依赖隐式去重,改写后需确保关联条件覆盖唯一约束,否则可能改变结果集。

如何将去重子查询改写为EXISTS
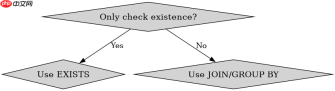
当子查询仅用于过滤主表记录而无需返回子表数据时,使用EXISTS比SELECT DISTINCT更高效。EXISTS在找到第一条匹配记录后即停止搜索,避免了全量去重计算。例如,查找有订单的客户,原查询用DISTINCT获取客户ID列表,改写后直接检查订单表中是否存在对应ID。这种改写利用了短路径退出机制,大幅减少处理行数。前提是子查询的关联字段有索引,且业务逻辑允许“存在即保留”的判断。
SELECT c.customer_id, c.name
FROM customers c
WHERE EXISTS (
    SELECT 1
    FROM orders o
    WHERE o.customer_id = c.customer_id
);
预期结果:返回所有至少有一笔订单的客户信息。执行计划显示NESTED LOOPS SEMI或HASH JOIN SEMI,而非HASH UNIQUE。若orders.customer_id有索引,Oracle会快速定位匹配行,无需扫描整个orders表进行去重。
如何用JOIN替代DISTINCT进行多表关联
当子查询需要返回具体列值时,EXISTS不适用,应改用INNER JOIN配合GROUP BY或DISTINCT。但更优解是利用主键或唯一索引进行JOIN,使Oracle自动去重。例如,获取客户及其最新订单日期,原查询用子查询DISTINCT去重,改写后通过JOIN关联订单表并按客户分组。若关联字段唯一,JOIN结果自然无重复,无需额外去重步骤。这减少了内存中的排序操作,提升并发处理能力。需注意JOIN条件必须精确匹配唯一键,否则会产生数据膨胀。


SELECT c.customer_id, c.name, MAX(o.order_date) as last_order
FROM customers c
JOIN orders o ON c.customer_id = o.customer_id
GROUP BY c.customer_id, c.name;
预期结果:每个客户一行,附带其最近订单日期。执行计划显示HASH GROUP BY,若customers.customer_id为主键,Oracle可利用索引快速聚合。相比原DISTINCT子查询,此方法避免了嵌套循环中的重复扫描,直接通过聚合函数计算最大值,效率更高。若orders表有大量历史数据,MAX函数可借助索引快速跳过旧记录。
基于orders表无索引时的性能瓶颈分析
当orders表的customer_id字段缺乏索引时,上述两种优化手段的效果会大打折扣。此时,Oracle无法快速定位匹配行,必须对orders表进行全表扫描。即使改用EXISTS或JOIN,数据库仍需读取所有订单记录以完成关联或存在性检查。这种情况下,DISTINCT子查询的性能劣势主要体现在内存排序上,而JOIN/EXISTS的劣势在于I/O开销。建议在此场景下优先为关联字段创建索引,或考虑物化视图预计算去重结果。若无索引,可尝试使用Hint强制Hash Join,但需监控PGA内存使用情况,避免磁盘临时表空间交换。


