






sql关联子查询引发大量逻辑读取的核心原因是它通常表现为“逐行执行”的嵌套循环模式,导致内层查询对每一行外层数据都重新扫描索引或表。要解决此问题,应将其改写为join操作或利用窗口函数,使数据库优化器能够选择更高效的哈希连接或合并连接策略,从而将多次随机i/o转化为一次性的批量处理。
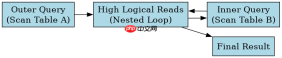
为什么关联子查询会导致重复扫描
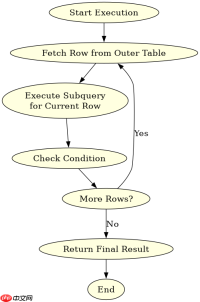
关联子查询的执行计划通常呈现为Nested Loops(嵌套循环),外层每返回一行,内层子查询就会作为驱动条件重新执行一次。如果内层没有合适的索引支持,或者即使有索引但选择性不高,数据库引擎就需要进行大量的逻辑读取来验证每一行的匹配情况。这种机制在数据量大时,I/O开销会呈线性甚至指数级增长。
SELECT * FROM Orders o
WHERE o.CustomerID IN (
    SELECT c.CustomerID
    FROM Customers c
    WHERE c.Region = 'North'
);
上述代码中,如果Orders表有10万行,而Customers表中Region='North'的有1000人,子查询可能被优化为Hash Match,但如果写成EXISTS且相关列未索引,则可能退化为全表扫描。关键在于理解执行计划中的“Loop”次数。
如何识别并避免这种性能陷阱
通过查看执行计划,若发现Nested Loops算子下挂载了Clustered Index Scan或Table Scan,且Outer References指向外部查询,即确认为关联子查询导致的性能瓶颈。避免方法包括:使用JOIN替代IN/EXISTS,确保关联字段有索引,或使用CTE预先过滤数据。
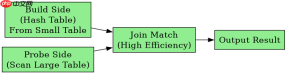
SELECT o.* FROM Orders o
INNER JOIN Customers c ON o.CustomerID = c.CustomerID
WHERE c.Region = 'North';
改写为JOIN后,数据库可以使用Hash Join或Merge Join,只需扫描一次Customers表和一次Orders表,大幅减少逻辑读取次数。这是解决关联子查询性能问题的标准做法。
基于具体输入条件的执行差异分析
当外层查询返回的行数极少,而内层查询需要扫描大量数据时,关联子查询的开销相对较小,因为重复执行的次数少。然而,当外层数据量巨大时,这种模式会成为严重的性能杀手。例如,在处理百万级订单时,关联子查询可能导致数千次的全表扫描,而JOIN操作仅需两次完整扫描。


