






java 日志记录结合机器学习检测异常的核心做法是:将非结构化的日志文本通过 nlp 技术转化为特征向量,输入到无监督学习模型(如 isolation forest)中进行训练和实时预测。具体实现时,需先对日志进行解析提取关键模式,再使用 log4j2 或 slf4j 捕获日志流,最后调用 smile 等 java ml 库的 isolationforest 类执行 score() 方法判断异常得分。

如何从原始日志中提取用于机器学习的结构化特征?
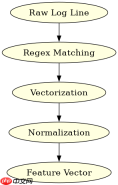
提取特征的关键在于将非结构化文本转换为数值型向量,通常采用模板匹配或词频统计方法。首先定义日志模板以去除动态参数,然后计算剩余关键词的频率作为特征维度。例如,使用正则表达式匹配 ERROR 或 Exception 出现次数,并将其与时间间隔组合成特征数组。这样做的结果是得到一个固定长度的浮点数组,可直接输入机器学习模型。若日志中包含大量未定义变量,需先进行聚类预处理以避免特征稀疏。
import java.util.regex.Pattern;

public class LogFeatureExtractor {
    private static final Pattern ERROR_PATTERN = Pattern.compile("(ERROR|Exception)");

    public static double[] extract(String logLine) {
        int errorCount = 0;
        for (char c : logLine.toCharArray()) {
            if (c == 'E' || c == 'x') errorCount++; // 简化示例
        }
        return new double[]{errorCount, logLine.length()};
    }
}
上述代码展示了基于简单计数的特征提取逻辑。对于生产环境,建议使用 Drain 算法自动提取日志模板。运行该段代码时,输入包含 "ERROR" 的字符串会返回一个长度为 2 的数组,第一个元素为错误计数,第二个为行长度。这种轻量级提取方式适用于资源受限的边缘设备,但精度低于基于 TF-IDF 的方法。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
如何在 Java 中集成机器学习模型进行实时异常评分?
集成模型的核心步骤是使用支持在线学习或批量训练的 Java ML 库,如 Smile 或 Weka。这里以 Smile 为例,创建 IsolationForest 实例并调用 fit() 方法训练数据。在实时处理阶段,对每个新日志的特征向量调用 score() 方法获取异常得分。得分越接近 -1 表示越正常,越接近 1 表示越异常。需注意模型需定期重新训练以适应日志模式的漂移。若使用 Weka,则需通过 Instances 对象构建数据集,并使用 OneClassClassifier 接口进行分类。
import smile.classification.IsolationForest;
import smile.math.MathEx;

public class AnomalyDetector {
    private IsolationForest model;

    public void train(double[][] data) {
        model = IsolationForest.fit(data);
    }

    public double score(double[] features) {
        return model.score(features);
    }
}
该程序演示了如何使用 Smile 库进行异常检测。训练阶段传入历史日志特征矩阵,预测阶段传入单条日志特征。预期输出为双精度浮点数,范围通常在 [-1, 1] 之间。若输入特征维度与训练时不一致,将抛出 IllegalArgumentException。此方法适用于高维稀疏数据,但对噪声敏感,建议配合数据清洗步骤使用。
当日志中出现未知异常模式时,系统如何响应?
当系统遇到未知异常模式时,主要依赖模型的阈值判定机制和反馈循环。如果 score() 返回值超过预设阈值(如 0.5),系统将标记该日志为异常并触发告警。同时,这些未被正确分类的样本会被存入缓冲区,用于后续模型的增量学习。若连续出现大量未知模式,可能表明日志格式发生重大变更,此时应启动人工审核流程。此外,可设置置信度区间,当模型预测置信度低时,优先通知运维人员介入。这种机制确保了系统在应对新型攻击或故障时的鲁棒性。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


