






go-zero框架中缓存设计应基于 core/cache 包提供的 onecache 结构,通过配置 redis 连接参数并指定键前缀来实现。具体做法是初始化 onecache 实例后,在业务逻辑中调用 get 或 set 方法,利用其内置的互斥锁机制防止缓存击穿。高并发场景下,建议结合 cache.withtimeout() 设置合理的过期时间,并使用 cache.withretry() 处理网络异常,确保服务稳定性。
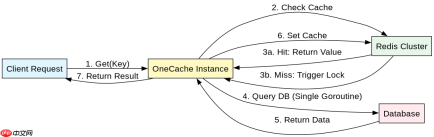
OneCache 如何防止缓存击穿?
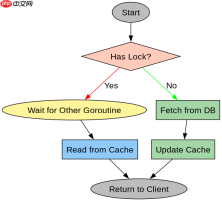
OneCache 通过内部互斥锁(Mutex)机制解决缓存击穿问题。当多个请求同时查询一个不存在的 Key 时,只有一个 goroutine 会去执行数据库查询并回填缓存,其他 goroutine 等待该 goroutine 完成后再读取缓存。这种“单飞”策略避免了大量请求直接穿透到后端数据库,保护了系统底层存储。
package main

import (
	"context"
	"fmt"
	"time"

	"github.com/zeromicro/go-zero/core/cache"
	"github.com/zeromicro/go-zero/core/logx"
)

func main() {
	// 1. 配置 Redis 连接
	redisConf := cache.RedisConf{
		Host: "127.0.0.1:6379",
		Type: "node",
	}

	// 2. 初始化 OneCache,设置超时和重试
	c := cache.New(redisConf, cache.WithTimeout(5*time.Second), cache.WithRetry())
	ctx := context.Background()
	key := "user:1001"

	// 3. 模拟获取数据
	var val string
	err := c.Get(key, &val)
	if err != nil {
		// 缓存未命中或出错
		logx.Info("Cache miss or error:", err)
		// 实际业务中这里会查 DB 并 Set
		val = "User-Name-From-DB"
		c.Set(key, val, 10*time.Minute)
	}
	fmt.Println("Result:", val)
}
预期结果:首次运行输出 User-Name-From-DB 并写入缓存;后续相同 Key 的请求直接从 Redis 读取,不再触发数据库逻辑。若 Redis 不可用且未配置重试,将返回错误而非穿透至 DB。
如何优化高并发下的缓存命中率与性能?
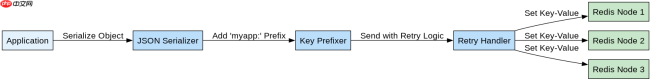
在高并发场景下,除了防止击穿,还需关注缓存的读写性能和一致性。Go-Zero 支持通过 cache.WithPrefix() 为所有 Key 添加统一前缀,便于管理不同业务的缓存空间。同时,使用 cache.WithSerializer() 可以自定义序列化方式,默认使用 Gob 序列化,但在跨语言或高性能要求下可替换为 JSON 或 Protobuf。此外,合理设置 TTL(生存时间)能减少内存占用,避免脏数据长期驻留。

package main

import (
	"context"
	"encoding/json"
	"fmt"
	"time"

	"github.com/zeromicro/go-zero/core/cache"
	"github.com/zeromicro/go-zero/core/mr"
)

// 自定义序列化器示例
var jsonSerializer = cache.SerializerFunc(func(v interface{}) ([]byte, error) {
	return json.Marshal(v)
})

func main() {
	redisConf := cache.RedisConf{Host: "127.0.0.1:6379", Type: "node"}
	// 使用前缀和自定义序列化
	c := cache.New(redisConf,
		cache.WithPrefix("myapp:"),
		cache.WithSerializer(jsonSerializer),
		cache.WithTimeout(3*time.Second))

	ctx := context.Background()
	type User struct { ID int; Name string }
	u := User{ID: 1, Name: "Alice"}

	// 批量设置测试
	keys := []string{"u1", "u2", "u3"}
	vals := []interface{}{u, u, u}

	// 使用 mr.Do 并行执行 Set 操作以提升吞吐
	tasks := make([]mr.Task, len(keys))
	for i, k := range keys {
		tasks[i] = func() error {
			return c.Set(k, vals[i], 5*time.Minute)
		}
	}
	mr.ParallelRun(tasks...)

	fmt.Println("Batch set completed")
}
预期结果:三个用户数据以 myapp:u1、myapp:u2、myapp:u3 格式存入 Redis,序列化结果为 JSON 字符串。并行执行显著降低总耗时,适合热点数据预热场景。
当 Redis 集群节点故障时,OneCache 的行为是什么?
当 Redis 集群中的某个节点发生故障时,OneCache 会根据配置的 WithRetry() 尝试重连或切换节点。如果重试次数耗尽仍无法连接,Get 操作将返回错误,而不会自动降级到数据库查询。开发者需在业务层捕获该错误,决定是直接返回默认值、空列表还是触发熔断机制。这种设计保证了缓存层的独立性,避免因缓存故障导致整个服务雪崩,但也要求业务代码具备完善的容错处理能力。












