






在goframe框架中配置数据库分库分表,核心在于使用 gdb 组件的 setconfig 方法注册多个数据源,并通过 tablerule 定义路由规则。你需要为每个物理数据库节点配置独立的连接信息,并指定一个全局唯一的逻辑表名,同时设置分片键(sharding key)和具体的分片算法(如取模或范围)。配置完成后,框架会在执行sql时自动根据分片键将请求路由到对应的物理库和表中,对业务代码透明。

如何配置多数据源与基础路由规则
配置多数据源的第一步是获取 gdb 实例并调用 SetConfig 传入包含 nodes 和 table_rules 的配置结构体。你需要定义至少两个节点来模拟分库,并为逻辑表绑定一个分片规则。这个规则必须指定 sharding_key,即用于计算路由的字段,以及 algorithm,即具体的分片策略函数。配置生效后,所有对该逻辑表的查询都会经过这个规则引擎。
package main

import (
	"context"
	"fmt"
	"github.com/gogf/gf/v2/database/gdb"
	"github.com/gogf/gf/v2/frame/g"
)

func main() {
	// 1. 初始化配置
	config := gdb.Config{
		Nodes: []gdb.ConfigNode{
			{
				Host:    "127.0.0.1",
				Port:    "3306",
				User:    "root",
				Pass:    "123456",
				Type:    "mysql",
				Name:    "db_shard_0",
			},
			{
				Host:    "127.0.0.1",
				Port:    "3306",
				User:    "root",
				Pass:    "123456",
				Type:    "mysql",
				Name:    "db_shard_1",
			},
		},
		Tables: []gdb.TableRule{
			{
				Name:       "user_info", // 逻辑表名
				ShardingKey: "uid",      // 分片键
				Algorithm: func(ctx context.Context, node *gdb.ConfigNode, table string, shardingKey interface{}) (result []string, err error) {
					// 简单取模算法:uid % 2
					if uid, ok := shardingKey.(int64); ok {
						index := uid % 2
						return []string{fmt.Sprintf("user_info_%d", index)}, nil
					}
					return nil, fmt.Errorf("invalid sharding key type")
				},
			},
		},
	}

	// 2. 设置全局配置
	gdb.SetConfig(config)

	// 3. 获取默认DB实例
	db := g.DB()

	// 4. 测试插入
	ctx := context.Background()
	_, err := db.Model("user_info").Data(g.Map{
		"uid": 101,
		"name": "Alice",
	}).Insert(ctx)
	if err != nil {
		fmt.Println("Insert Error:", err)
	} else {
		fmt.Println("Insert Success")
	}

	// 5. 测试查询
	res, err := db.Model("user_info").Where("uid", 101).One(ctx)
	if err != nil {
		fmt.Println("Query Error:", err)
	} else {
		fmt.Println("Query Result:", res)
	}
}
上述代码展示了完整的配置流程。首先定义了 db_shard_0 和 db_shard_1 两个物理库节点。接着在 Tables 中定义了逻辑表 user_info,其分片键为 uid。算法部分实现了简单的取模逻辑,将偶数UID路由到 user_info_0,奇数UID路由到 user_info_1。最后通过 g.DB() 获取实例并进行操作。注意,物理数据库中必须预先创建好对应的表结构,否则插入会报错。
如何实现基于范围的动态分表
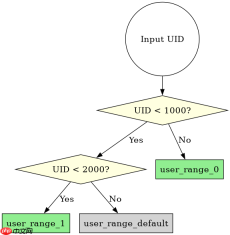
当数据量极大且需要按时间或ID范围扩展时,取模算法可能导致数据倾斜或扩容困难。此时可以使用范围分片算法。在 Algorithm 回调中,你可以实现更复杂的逻辑,例如根据UID的范围返回不同的表名。这种方式允许你手动控制哪些UID落在哪个表中,适合预分表场景。配置方式与基础路由一致,仅改变 Algorithm 内部的判断逻辑。

Drizzle ORM 是一个轻量级的 TypeScript ORM,提供类型安全的 SQL 模式声明、关系型和类 SQL 查询构建器,以及自动生成迁移。其压缩后仅 7.4kb,且无依赖项,支持 PostgreSQL、MySQL 和 SQLite,包括 Neon、Turso 和 Cloudflare D1 等无服务器数据库。
// 修改之前的 Algorithm 部分
Algorithm: func(ctx context.Context, node *gdb.ConfigNode, table string, shardingKey interface{}) (result []string, err error) {
	if uid, ok := shardingKey.(int64); ok {
		// 范围分片示例:
		// 0-999 -> user_range_0
		// 1000-1999 -> user_range_1
		// 其他 -> user_range_default
		if uid <p>这种范围分片的优势在于,如果你知道某个时间段的数据量,可以提前规划好表的数量。例如,每月新增10万用户,就可以按月创建表。缺点是如果数据分布不均,某些表可能会过大。在实际使用中,建议结合监控数据定期调整范围阈值,或者采用一致性哈希等更高级的算法来平衡负载。无论哪种算法,最终返回的都是一个字符串切片,表示该条记录可能存在的物理表列表,框架会根据这个列表去对应的库中查找或写入。</p><p><img src="https://img.php.cn/upload/article/001/589/237/179524365183540.png?x-oss-process=image/resize,p_40" alt="GoFrame框架怎么配置数据库分库分表"></p><h2>跨库关联查询如何处理</h2><p>在使用分库分表后,最棘手的问题是跨库关联查询(Join)。由于数据被分散在不同的物理库中,传统的SQL Join无法直接工作,因为数据库之间没有直接的视图关联。GoFrame的分库分表功能主要解决单表的路由问题,对于Join操作,通常需要在应用层解决。一种常见做法是将关联数据冗余到同一张表中,或者在查询时先查出主表数据,再根据分片键分别查询从表数据,最后在内存中进行组装。另一种方式是使用全局唯一索引或分布式ID生成器,确保关联键也能正确路由。如果必须使用Join,可以考虑使用中间件或专门的分布式数据库解决方案,但这超出了GoFrame原生 <code>gdb</code> 的范畴。因此,在设计表结构时,尽量避免强关联,优先采用NoSQL式的文档存储或微服务间的数据同步机制。</p>












