






java中利用hashset作为缓存去重,核心做法是调用其add()方法,该方法在元素不存在时返回true并添加元素,存在时返回false。通过判断返回值即可实现“只处理新数据”的逻辑,同时利用哈希表o(1)的时间复杂度保证高效性。
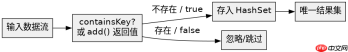
如何编写基于HashSet的过滤代码
直接回答:使用Set存储已见数据,遍历输入列表时检查set.add(item)的返回值,为true则保留该数据。
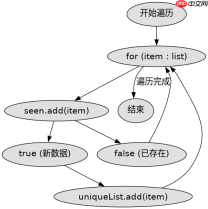
import java.util.*;

public class CacheDemo {
    public static void main(String[] args) {
        List<string> input = Arrays.asList("A", "B", "A", "C", "B");
        Set<string> seen = new HashSet();
        List<string> uniqueList = new ArrayList();

        for (String item : input) {
            if (seen.add(item)) { // 如果添加成功(之前未包含)
                uniqueList.add(item);
            }
        }
        System.out.println(uniqueList); // 输出: [A, B, C]
    }
}</string></string></string>
如何处理对象类型的去重
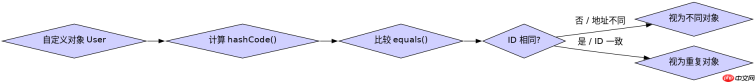
直接回答:对于自定义对象,必须重写equals()和hashCode()方法,否则HashSet将基于内存地址进行去重,导致逻辑错误。

在架构漂移扩散之前,使用 dependency-cruiser 强制执行 JavaScript 和 TypeScript 依赖规则
下载
在代码库出现结构漂移之前,扫描JS或TS代码库中的禁止导入、循环依赖、孤立模块和其他依赖规则违规情况。
import java.util.*;

class User {
    String id;
    User(String id) { this.id = id; }
    @Override
    public boolean equals(Object o) {
        return o instanceof User && ((User) o).id.equals(this.id);
    }
    @Override
    public int hashCode() {
        return id.hashCode();
    }
}

public class ObjectCacheDemo {
    public static void main(String[] args) {
        List<user> users = Arrays.asList(
            new User("1"), new User("1"), new User("2")
        );
        Set<user> cache = new HashSet();
        for (User u : users) {
            cache.add(u); // 只有第一个User("1")会被加入
        }
        System.out.println(cache.size()); // 输出: 2
    }
}</user></user>
当输入数据为空或重复率极高时会发生什么
直接回答:若输入为空,循环不执行,结果集保持初始状态;若重复率极高,HashSet内部哈希桶冲突增加,但平均时间复杂度仍维持在O(1),仅常数级性能损耗。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


