






nginx 平滑重载后内存增长通常是因为旧进程未完全释放或配置中开启了调试日志。解决该问题的核心做法是确保 nginx 正确执行了信号处理,并检查 `error_log` 是否被意外开启。如果重启后内存持续上涨,重点排查是否因并发连接数激增导致旧 worker 进程持有大量文件描述符未及时关闭。
如何正确执行平滑重载操作
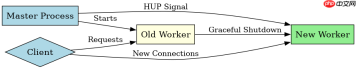
平滑重载通过发送 HUP 信号实现,Nginx master 进程接收信号后会启动新版本的 worker 进程,并通知旧 worker 进程停止接受新连接,待现有请求处理完毕后退出。这一过程保证了服务不中断。执行命令为 nginx -s reload 或在 systemd 环境下使用 systemctl reload nginx。关键在于确认新旧进程共存的时间窗口内,资源分配是否正常。
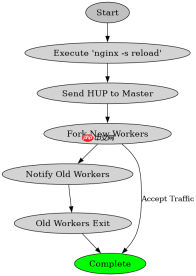
nginx -s reload
ps aux | grep nginx
上述命令执行后,通过 ps 命令可以观察到进程列表中同时存在多个 nginx: worker process。旧进程在处理完所有活跃连接后会自动退出,新进程接管流量。若发现进程数量异常增加且不减少,说明旧进程可能卡死或未收到正确的退出信号。
为什么重载后内存占用会升高
内存升高的常见原因包括:一是 error_log 级别被设置为 debug,导致日志文件急剧膨胀并占用大量内存缓冲;二是旧 worker 进程在优雅退出过程中,由于网络延迟或客户端未断开,导致连接堆积,内存无法及时回收;三是使用了第三方模块(如 Lua)且未正确清理全局状态。默认情况下,Nginx 的内存管理是高效的,异常增长往往源于配置错误或外部压力。


# 检查 error_log 配置
error_log /var/log/nginx/error.log warn;
将日志级别调整为 warn 或 error 可显著降低内存开销。此外,检查 worker_connections 设置,过高的值会导致每个 worker 预分配过多内存。若怀疑是特定模块问题,可尝试禁用非核心模块进行对比测试。
重载后如何验证内存是否恢复正常
验证方法是通过监控工具观察 VSS(虚拟内存大小)和 RSS(物理内存驻留集)的变化趋势。平滑重载后,RSS 应在新旧进程切换完成后逐渐回落至基线水平。可以使用 top 或 htop 实时查看,或使用 pidstat 记录历史数据。若 RSS 持续高于基线 20% 以上,需进一步分析。
pidstat -r -p <master_pid> 1</master_pid>
运行上述命令可每秒输出一次指定进程的内存统计信息。重点关注 %MEM 和 RSS 列。如果数值稳定且无持续增长趋势,则表明内存管理正常。若发现持续增长,结合前文提到的日志和连接数问题进行排查。


