






java hashmap 在并发 put 时主要会导致数据丢失、死循环(仅限 jdk 1.7)以及线程安全问题。具体做法是避免在多线程环境下直接使用 hashmap,改用 concurrenthashmap 或 collections.synchronizedmap()。
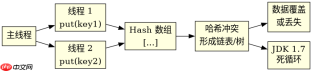
JDK 1.7 中并发 put 为何会引发死循环
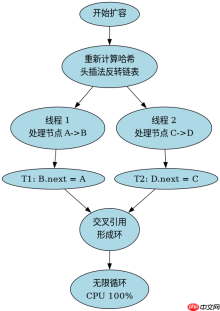
在 JDK 1.7 中,HashMap 采用头插法进行链表插入。当两个线程同时触发扩容 rehash 时,由于链表反转操作的非原子性,可能导致环形链表的出现,进而使 get 或 size 操作陷入无限循环。这是最严重的并发问题之一。
import java.util.HashMap;
import java.util.Map;

public class HashMapDeadLoop {
    public static void main(String[] args) {
        Map<integer string> map = new HashMap(2);
        // 模拟触发扩容的初始状态
        map.put(5, "A");
        map.put(25, "B");

        Thread t1 = new Thread(() -> {
            for (int i = 0; i  {
            for (int i = 10000; i <p>上述代码在 JDK 1.7 下运行极大概率导致 CPU 100% 并卡死。JDK 1.8 改为尾插法,解决了死循环问题,但仍存在数据覆盖风险。</p>
<h2>JDK 1.8+ 中并发 put 导致的数据覆盖问题</h2>
<p>JDK 1.8 虽然通过尾插法避免了死循环,但 put 操作依然不是原子的。当多个线程同时向同一个桶(Bucket)插入元素时,后执行的线程可能会直接覆盖前一个线程插入的节点,导致数据丢失。此外,get 操作可能读到 null 值或旧值,因为读操作没有加锁保护。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill13505" title="FilePond 灵活的 JavaScript 文件上传库"><img
														src="https://img.php.cn/upload/skill/001/246/273/6adaf20e695c2374.jpg" alt="FilePond 灵活的 JavaScript 文件上传库" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill13505" title="FilePond 灵活的 JavaScript 文件上传库" class="overflowclass">FilePond 灵活的 JavaScript 文件上传库</a>
													<p class="overflowclass">FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill13505" title="FilePond 灵活的 JavaScript 文件上传库" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div>
<p><img src="https://img.php.cn/upload/article/001/242/473/179523302855001.png?x-oss-process=image/resize,p_40" alt="Java HashMap 并发 put 会导致什么问题"></p>
<pre class="brush:php;toolbar:false;">import java.util.HashMap;
import java.util.Map;
import java.util.concurrent.atomic.AtomicInteger;

public class HashMapDataLoss {
    public static void main(String[] args) throws InterruptedException {
        Map<string atomicinteger> map = new HashMap;
        // 初始化一个共享的计数器
        map.put("counter", new AtomicInteger(0));

        int threadCount = 10;
        Thread[] threads = new Thread[threadCount];

        for (int i = 0; i  {
                for (int j = 0; j  modify -> put
                    AtomicInteger counter = map.get("counter");
                    if (counter == null) {
                        counter = new AtomicInteger(0);
                        map.put("counter", counter); // 竞态条件
                    }
                    counter.incrementAndGet();
                    map.put("counter", counter);
                }
            });
            threads[i].start();
        }

        for (Thread t : threads) t.join();

        System.out.println("Expected: 10000, Actual: " + map.get("counter").get());
    }
}</string>
该程序预期输出 10000,但实际输出通常小于 10000,因为多个线程同时读取到相同的 counter 对象,各自递增后写回,覆盖了彼此的增量。这就是典型的数据覆盖问题。
基于 ConcurrentHashMap 解决并发问题的具体实现
针对上述并发问题,最佳实践是使用 ConcurrentHashMap。它通过分段锁(JDK 1.7)或 CAS + synchronized(JDK 1.8)实现了细粒度的并发控制,保证了 put 操作的原子性和可见性,同时支持高并发读写。
import java.util.concurrent.ConcurrentHashMap;
import java.util.concurrent.atomic.AtomicInteger;

public class SafeConcurrentExample {
    public static void main(String[] args) throws InterruptedException {
        ConcurrentHashMap<string atomicinteger> map = new ConcurrentHashMap;
        map.put("counter", new AtomicInteger(0));

        int threadCount = 10;
        Thread[] threads = new Thread[threadCount];

        for (int i = 0; i  {
                for (int j = 0; j  {
                        if (v == null) return new AtomicInteger(1);
                        v.incrementAndGet();
                        return v;
                    });
                }
            });
            threads[i].start();
        }

        for (Thread t : threads) t.join();

        System.out.println("Safe Result: " + map.get("counter").get());
    }
}</string>
此代码使用 compute 方法,确保了对 counter 的读取、修改和写入在一个原子操作中完成,最终结果必定为 10000,彻底解决了数据覆盖问题。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


