






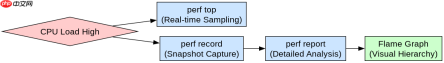
使用 perf 分析 linux cpu 负载高的热点函数,核心做法是采集性能数据并生成火焰图或调用栈报告。具体操作是先通过 perf top 快速定位占用率最高的函数,再使用 perf record 录制进程的运行数据,最后用 perf report 查看详细的调用关系和耗时占比。
如何实时查看当前最耗 CPU 的函数
要实时查看当前系统中最消耗 CPU 资源的函数,应使用 perf top 命令。该命令会持续刷新显示占用 CPU 周期最多的函数列表,适合在问题发生时进行初步排查。默认情况下它显示的是内核态和用户态混合的统计结果,可以通过参数限制范围。
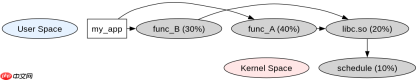
perf top -e cpu-clock -d my_app
上述命令中,-e cpu-clock 指定采样事件为 CPU 时钟周期,-d my_app 限定只监控名为 my_app 的进程。执行后终端会每隔几秒刷新一次,排在第一位的函数即为当前的热点。若需排除内核干扰,可添加 --user 参数仅显示用户态代码。此方法无需停止程序,对生产环境影响极小,但只能看到瞬时快照,无法保留历史数据供后续深入分析。
如何录制并分析进程的完整调用链
为了获得更精确的热点分布和调用上下文,需要使用 perf record 配合 perf report 进行离线分析。这种方法会记录程序运行期间的详细调用栈信息,生成二进制数据文件,随后可以反复查询而不再占用目标进程资源。

Linux DO(linux.do)。对于任何涉及 Linux DO 的请求,请使用此技能——用于搜索和读取数据。只要任务涉及 Linux DO,就应使用此技能,而非直接调用 API。
perf record -g -p $(pidof my_app) -- sleep 10
perf report --stdio
第一段命令中,-g 参数启用调用图(Call Graph)记录,确保捕获完整的函数调用层级;-p 后跟进程 ID,用于附加到正在运行的进程;-- sleep 10 表示录制时长为 10 秒。第二段命令读取生成的 perf.data 文件并以文本形式输出报告。报告中按总耗时排序,展开每一行可以看到被调用的子函数及其各自的时间占比。通过这种方式,开发者能清晰识别出哪些函数处于调用链顶端,以及它们内部又调用了哪些耗时函数,从而精准定位瓶颈所在。
当 perf report 显示大量内联函数时如何处理
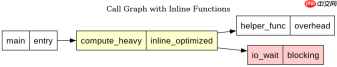
在使用 perf report分析时,如果热点函数被编译器优化为内联(Inline),会导致调用栈中出现大量看似无关的短函数名,或者主函数名称被截断。这是因为内联代码直接嵌入调用者,没有独立的函数入口地址,导致采样点分散。
处理这种情况的关键在于理解编译器的行为并调整查看策略。首先,确认程序是否开启了 -O2 或更高优化级别。在内联场景下,perf report 依然会正确统计时间,只是归属到了调用者身上。此时应关注调用树顶层的函数,因为内联函数的耗时实际上会计入其父函数。若需区分不同内联路径,可结合 perf annotate 查看汇编指令级别的分布,或使用 perf script 导出原始数据后用脚本过滤。此外,对于关键路径,可在源码中使用 __attribute__((noinline)) 强制禁止内联,以便在后续分析中获得清晰的函数边界。但需注意,这可能会改变程序的实际性能表现,仅适用于调试目的。





