






xorm框架的iterate方法通过底层游标机制处理大数据量,避免一次性加载导致内存溢出。调用时只需传入模型实例和回调函数,xorm会自动分批查询并逐行执行逻辑。这种方式适合处理百万级以上的数据,但需注意在回调中保持轻量操作以维持吞吐效率。

Iterate与Find在内存占用上的区别是什么
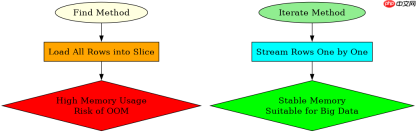
Iterate使用流式读取,内存占用恒定;而Find会将所有结果集加载到切片中,内存随数据量线性增长。对于超过数万条的记录,强烈建议使用Iterate以避免OOM(Out Of Memory)错误。
package main

import (
    "fmt"
    "log"
    "github.com/xormplus/xorm"
)

type User struct {
    ID   int64  `xorm:"pk autoincr"`
    Name string `xorm:"varchar(50)"`
}

func main() {
    // 假设 engine 已正确初始化并连接数据库
    var user User
    err := engine.Iterate(&user, func(rowsRows) error {
        fmt.Printf("Processing user: %s\n", rows.Name)
        return nil
    })
    if err != nil {
        log.Fatal(err)
    }
}
上述代码展示了基本用法。当数据量极大时,Find需要分配巨大的切片空间,而Iterate仅维护当前行的对象实例。若需批量更新或复杂计算,可在回调内部实现,但应避免在循环内执行耗时IO操作。
如何在迭代过程中安全地修改正在遍历的数据
在Iterate的回调函数中直接修改传入的模型实例字段是安全的,因为每次迭代都会重新查询下一行数据覆盖该实例。但如果需要持久化修改,必须显式调用Update方法,否则修改仅存在于内存中不会写入数据库。


package main

import (
    "fmt"
    "log"
    "github.com/xormplus/xorm"
)

type Product struct {
    ID     int64  `xorm:"pk autoincr"`
    Price  float64 `xorm:"decimal(10,2)"`
    Status int     `xorm:"int"`
}

func main() {
    var product Product
    // 假设我们要将所有状态为0的商品价格打9折
    err := engine.Where("status = ?", 0).Iterate(&product, func(rowsRows) error {
        originalPrice := product.Price
        product.Price = originalPrice * 0.9

        // 必须显式更新,否则内存中的改变不会同步到DB
        _, err := engine.ID(product.ID).Cols("price").Update(&product)
        if err != nil {
            return err
        }
        fmt.Printf("Updated product %d: %.2f -> %.2f\n", product.ID, originalPrice, product.Price)
        return nil
    })
    if err != nil {
        log.Fatal(err)
    }
}
此示例演示了在迭代中结合条件过滤进行原地更新。关键点在于Where子句限制了扫描范围,减少了不必要的数据传输。同时,每次更新都指定了Cols以确保只更新价格字段,提高并发安全性。回调函数返回非空错误会立即终止迭代,因此错误处理至关重要。
基于Iterate回调返回错误时的中断行为是怎样的
当Iterate的回调函数返回非nil错误时,迭代过程会立即停止,不再处理后续记录。此时Iterate方法本身也会返回该错误,调用者可以据此判断是否发生异常或业务逻辑中断。这种设计允许在遇到脏数据或特定条件时快速退出,节省资源。











