






调整go-zero框架rpc连接超时和客户端重试,核心在于修改服务配置中的 timeout 字段以及启用 retry 开关。在 etc/xxx-api.yaml 或 etc/xxx-core.yaml 中,找到对应的 endpoints 列表,为每个节点设置具体的超时毫秒数,并开启 retry 选项以自动处理网络抖动。
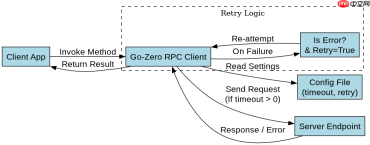
Timeout 参数如何精确控制单次请求耗时
通过设置 Timeout 数值,可以强制客户端在指定毫秒内未收到响应时断开连接并报错。该值直接映射到底层 grpc.DialOption 的 WithTimeout 或 context.WithTimeout,确保资源不会因服务端挂起而无限期占用。
package main

import (
	"context"
	"fmt"
	"time"

	"github.com/zeromicro/go-zero/core/service"
	"github.com/zeromicro/go-zero/zrpc"
)

type Config struct {
	Name    string `json:"name"`
	Timeout int64  `json:"timeout"`
	Retry   bool   `json:"retry"`
}

func main() {
	// 模拟配置:超时500ms,开启重试
	cfg := Config{
		Name:    "test",
		Timeout: 500,
		Retry:   true,
	}

	// 构建RPC客户端
	client := zrpc.MustNewClient(zrpc.RpcClientConf{
		Endpoints: []string{"127.0.0.1:8080"},
		Timeout:   cfg.Timeout,
		Retry:     cfg.Retry,
	})

	ctx, cancel := context.WithTimeout(context.Background(), time.Duration(cfg.Timeout)*time.Millisecond)
	defer cancel()

	// 实际调用示例(需替换为真实Stub)
	// resp, err := client.Stub.Say(ctx, &pb.Request{Name: cfg.Name})
	// if err != nil {
	// 	fmt.Println("Error:", err)
	// }

	fmt.Printf("Configured Timeout: %d ms\n", cfg.Timeout)
	fmt.Printf("Retry Enabled: %v\n", cfg.Retry)
}
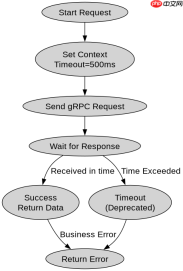
运行上述代码并检查日志,若服务端故意延迟超过 500 毫秒,客户端将抛出 context deadline exceeded 错误。若 Retry 为 true,框架会在捕获到网络级错误(如连接重置、超时)时自动发起第二次请求,直到达到内部默认的最大重试次数(通常为3次)或成功返回。
Retry 机制在什么条件下触发重连
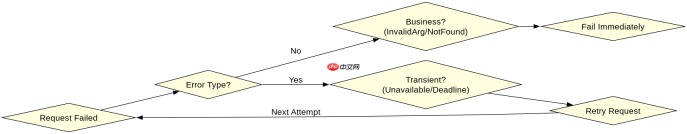
Retry 开关并非对所有错误生效,它主要针对 transient errors(瞬时错误)。当底层 gRPC 返回 Unavailable、DeadlineExceeded 或连接被拒绝时,重试逻辑才会介入。如果是业务逻辑错误(如参数校验失败),重试无效且浪费资源。

package main

import (
	"fmt"
	"net"
	"time"

	"google.golang.org/grpc"
	"google.golang.org/grpc/status"
)

func simulateNetworkFailure() error {
	// 模拟一个不可达的地址,触发连接超时
	conn, err := grpc.Dial("127.0.0.1:9999", grpc.WithInsecure(), grpc.WithBlock())
	if err != nil {
		return err
	}
	defer conn.Close()
	return nil
}

func checkRetryCondition(err error) bool {
	// 检查错误类型是否适合重试
	if err == nil {
		return false
	}
	// 在go-zero源码中,通常检查是否为gRPC的Unavailable或DeadlineExceeded
	// 这里简化演示判断逻辑
	st, ok := status.FromError(err)
	if !ok {
		// 非gRPC错误,如net.OpError,通常也是可重试的网络问题
		return true
	}
	// Unavailable (14) 和 DeadlineExceeded (4) 是典型的可重试状态码
	return st.Code() == codes.Unavailable || st.Code() == codes.DeadlineExceeded
}

func main() {
	// 启动一个假服务器监听以便测试连接建立,或直接测试超时
	ln, _ := net.Listen("tcp", ":0")
	addr := ln.Addr().String()
	fmt.Printf("Listening on %s\n", addr)

	// 实际测试中,关闭端口或高负载会导致上述checkRetryCondition返回true
	// 从而触发go-zero内部的retry逻辑
	fmt.Println("Retry logic depends on error code mapping.")
}
在实际排查中,如果发现请求频繁重试但依然失败,需检查服务端是否处于健康状态。Go-Zero 的重试策略是指数退避的,第一次失败后等待短暂时间再试,后续等待时间逐渐增加。这能有效防止在集群重启或扩容期间对后端造成二次冲击。配置 Retry: true 后,无需手动编写 for 循环进行重试,框架会自动处理上下文传递和错误分类。
服务端无响应时 Timeout 与 Retry 的组合行为
当服务端完全无响应(如进程僵死但未断网)时,Timeout 会先于 Retry 触发。客户端在等待 Timeout 设定的时长后,认为本次请求失败,此时若 Retry 开启,则立即启动下一次尝试。这种组合确保了在高延迟或偶发故障场景下的可用性。












