






java 标准库的 longstream 没有直接提供类似 scala 或 rxjava 中的 scan(前缀聚合)方法,但可以通过 reduce 结合自定义的累加器逻辑来实现。核心做法是维护一个状态对象,该对象包含当前累积值和结果列表,在 reduce 的过程中不断将中间结果存入列表,最后提取列表作为最终输出。
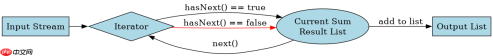
如何实现 LongStream.scan 的前缀聚合逻辑
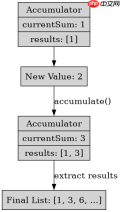
要实现前缀聚合,需要创建一个持有 List 和当前 long 值的容器类。使用 reduce(identity, accumulator, combiner) 的三参数形式。初始状态下,容器包含第一个元素和空列表。每次遇到新元素时,更新累积值并将旧累积值加入列表。由于 LongStream 是原始类型流,无法直接使用泛型对象作为累加器,因此通常需要将流转换为 Stream 或使用 mapToObj 包装后处理,或者手动迭代。这里展示一种基于 Stream 的标准实现方式,它清晰地展示了状态转移过程。
import java.util.*;
import java.util.stream.*;

public class ScanExample {
    static class Accumulator {
        long currentSum;
        List<long> results = new ArrayList();

        Accumulator(long first) {
            this.currentSum = first;
            this.results.add(first);
        }

        Accumulator accumulate(long value) {
            this.currentSum += value;
            this.results.add(this.currentSum);
            return this;
        }

        // 并行流时需要合并两个累加器
        Accumulator combine(Accumulator other) {
            // 注意:简单的 combine 不能直接拼接列表,因为前缀依赖全局顺序
            // 对于 scan,通常不建议并行,或者需要复杂的索引对齐
            // 此处仅为演示签名,实际 scan 很难高效并行化
            return null;
        }
    }

    public static List<long> scan(LongStream stream) {
        Iterator<long> iter = stream.iterator();
        if (!iter.hasNext()) return Collections.emptyList();

        Accumulator acc = new Accumulator(iter.next());
        while (iter.hasNext()) {
            acc.accumulate(iter.next());
        }
        return acc.results;
    }

    public static void main(String[] args) {
        LongStream stream = LongStream.of(1, 2, 3, 4, 5);
        List<long> result = scan(stream);
        System.out.println(result); // [1, 3, 6, 10, 15]
    }
}</long></long></long></long>
上述代码通过手动迭代 LongStream 避免了装箱开销,同时保持了 scan 的语义。如果必须使用 Stream 的链式调用,可以使用 collect 操作,其供应商、积累器和组合器逻辑与上述 Accumulator 类一致。关键点在于 scan 的输出长度与输入相同,且每个输出依赖于之前所有输入的累积。
如何处理空流和单元素流的边界情况
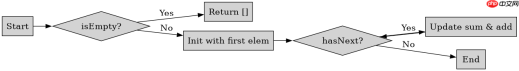
在处理流时,空流和单元素流是常见的边界条件。对于空流,scan 应返回空列表。对于单元素流,结果列表应仅包含该元素本身。在之前的 scan 实现中,我们使用了 iterator() 来手动控制流程,这天然地处理了这些情况:如果 hasNext() 初始为假,直接返回空列表;如果只有一个元素,循环不执行,只添加初始元素到结果集。这种手动迭代的方式比尝试构建复杂的 reduce 链更直观且不易出错,特别是在需要保留历史状态(如整个前缀列表)时。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
import java.util.*;
import java.util.stream.*;

public class EdgeCaseScan {
    public static List<long> safeScan(LongStream stream) {
        Iterator<long> iter = stream.iterator();
        if (!iter.hasNext()) {
            return Collections.emptyList();
        }

        List<long> results = new ArrayList();
        long current = iter.next();
        results.add(current);

        while (iter.hasNext()) {
            current += iter.next();
            results.add(current);
        }
        return results;
    }

    public static void main(String[] args) {
        // 测试空流
        System.out.println(safeScan(LongStream.empty())); // []

        // 测试单元素
        System.out.println(safeScan(LongStream.of(10))); // [10]

        // 测试正常流
        System.out.println(safeScan(LongStream.of(1, 2, 3))); // [1, 3, 6]
    }
}</long></long></long>
这段代码验证了边界条件的处理。空流返回空集合,单元素流返回仅含该元素的列表。这种实现方式简单、高效,且完全符合 LongStream 的性能要求,避免了不必要的对象创建。在实际开发中,如果数据量极大,可以考虑使用 ArrayList 的预分配容量来减少扩容开销,例如根据预估大小初始化列表。
为什么 LongStream 不提供原生的 scan 方法
LongStream 专注于原始长整型的操作,旨在避免装箱带来的性能损耗。而 scan 操作通常需要维护一个可变的状态容器(如列表),这在原始类型流中难以直接表达而不引入装箱。Java 设计者可能认为 reduce 已经足够强大,可以通过自定义累加器实现 scan,因此未将其作为内置方法。此外,scan 的并行化非常困难,因为每个元素的结果依赖于前面所有元素,这使得它在并行流场景下价值降低。开发者可以根据具体需求选择手动迭代或 Stream 的 collect 方式来实现这一功能。
大量免费API接口:立即使用
涵盖生活服务API、金融科技API、企业工商API、等相关的API接口服务。免费API接口可安全、合规地连接上下游,为数据API应用能力赋能!


