截至11月20日,openai开发者文档已提供gpt-live-1.1的模型和接入说明。这款全双工语音模型可以一边聆听一边说话,并把需要推理或工具调用的工作交给独立后端。语音对话与后台任务因此可以分别管理,但应用仍需负责权限、实际动作及完成结果的确认。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
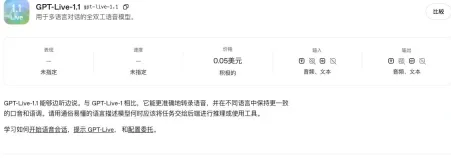
官方说明音频与文本输入输出,以及语音模型和后端任务的分工。
语音前端不需要承包所有复杂任务
GPT-Live处理交谈方式、打断与何时请求后端帮助。相比GPT-Live-1,官方描述1.1改进了转录准确性及跨语言口音和声音一致性;这些是产品能力说明,不是本文自行测得的准确率数据。
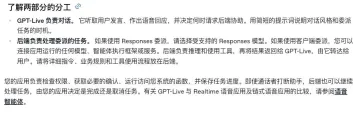
业务规则、工具执行和任务进度仍需要应用层管理。
两种委托模式覆盖不同后端
Responses委托由OpenAI运行支持的Responses模型并在语音与后端之间传递上下文和结果,自定义函数工具仍由开发者的应用执行。客户端委托则可连接应用自己的模型、代理框架或服务;选择哪种模式取决于后端控制需求,而不是语音模型必须与后端使用同一系列。
会话打断与任务取消不是同一动作
后端可以在用户继续补充或打断语音时工作,应用需要决定原任务是继续、修改还是取消,并识别重连后的已完成动作。模型直接输入输出支持文本与音频,不直接接收图片或视频;需要视觉信息时,应由有视觉能力的后端处理,再把结果传回语音会话。

官方推荐浏览器、移动端和服务端音频使用WebRTC,也支持WebSocket等连接方式。项目API密钥应保留在可信服务器;开发者还需分别验证业务动作真正完成,以及用户实际听到了相应结果,不能只把一次语音回答当成任务已经执行。
大量免费API接口:立即使用
涵盖生活服务API、金融科技API、企业工商API、等相关的API接口服务。免费API接口可安全、合规地连接上下游,为数据API应用能力赋能!