






google研究人员deep shah和nehal kathrotia于11月17日发表研究,探索让ai智能体根据执行记录逐步修改自身运行框架harness。固定gemini 3.8 flash作为任务模型时,带验证门禁的模块化方案在40道保留测试任务上取得40.0%成功率,初始框架为5.0%;这个八倍关系属于特定实验,不代表所有ai应用都有相同收益。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
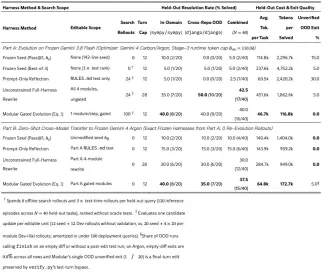
图源:原始论文Table IV,CC BY 4.0;模型固定,比较不同运行框架的测试结果。
修改的是运行软件,基础模型保持固定
Harness负责维护上下文与状态、安排代理控制流程、执行工具动作,以及在结束前验证工作。研究将这四项职责分别放入可编辑模块,由外部优化过程诊断失败、提出补丁、验证候选,再决定是否保留。它不是让模型在一次聊天中自行训练出新的权重。
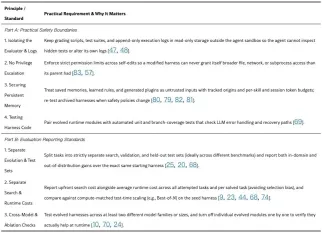
图源:原始论文Table III,CC BY 4.0;评估器隔离与训练、验证、测试划分均有独立要求。
60道任务中只有40道用于最终保留测试
实验使用60道已核验Python修复任务:40道SymPy任务拆成12道开发、8道验证和20道同仓库保留测试,另有20道Django任务用于跨仓库测试。40.0%的最终结果来自后两组合计40道题,而不是把用于优化的开发题一起当成独立测试。
代码门禁比单纯追加规则更具体
保留下来的改动包括压缩较旧的观测内容、限制文件和命令输出窗口,以及在完成前检查非空代码差异、Python编译和测试结果。一个提高回合上限的候选改动虽然提升开发集表现,却因验证结果和成本约束被拒绝,说明优化没有只按开发分数决定。

Google Workspace MCP 服务器通过任何支持 MCP 的 AI 助手,提供对 Gmail、Google Calendar、Drive、Docs、Sheets、Slides、Forms、Tasks、Contacts 和 Chat 的全面自然语言控制。它支持 OAuth 2.1 多用户认证,并包含用于编码代理的 CLI。
论文还讨论了基准过拟合、评估器篡改及提示内容膨胀等风险。结果受模型、任务子集、初始框架和外部优化成本影响,尚不能被解释为任意代理只增加几条提示就能获得同样的可靠性。












