






Oracle存储过程中执行MERGE INTO比先查后更效率高多少应如何调优
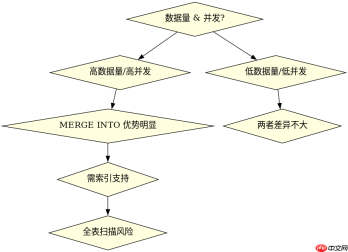
merge into 在大多数场景下比先查后更(select + insert/update)效率更高,因为它将数据读取、匹配和写入合并为单次操作,减少了上下文切换和锁竞争。具体提升幅度取决于数据量、索引覆盖率和并发冲突情况,通常在高并发或大数据量批量处理时优势明显。调优核心在于确保 on 条件列有合适索引、使用 /*+ append */ 提示进行直接路径加载、以及合理设置 rows 批次大小以避免回滚段压力。
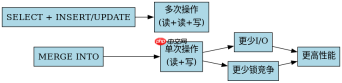
MERGE INTO 与 SELECT+INSERT/UPDATE 的性能对比及适用场景
当目标表数据量大且源表数据需要频繁更新时,MERGE INTO 能显著减少 I/O 开销。先查后更模式需要两次完整的表扫描或索引查找,而 MERGE INTO 只需一次。但在小数据量或简单插入场景下,两者差异不大,甚至先查后更可能因逻辑简单而略快。关键在于避免 MERGE INTO 中的全表扫描,确保连接条件高效。
CREATE OR REPLACE PROCEDURE merge_demo AS
BEGIN
  MERGE INTO target_table t
  USING source_table s
  ON (t.id = s.id)
  WHEN MATCHED THEN
    UPDATE SET t.name = s.name, t.value = s.value
  WHEN NOT MATCHED THEN
    INSERT (id, name, value) VALUES (s.id, s.name, s.value);
END;
/
预期结果:程序成功执行,target_table 中与 source_table id 匹配的记录被更新,不匹配的记录被插入。无异常抛出。
如何通过索引和 Hint 优化 MERGE INTO 的执行计划
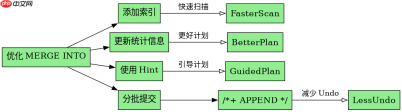
优化 MERGE INTO 的关键是强制优化器使用高效的访问路径。如果 ON 条件列没有索引,MERGE INTO 会退化为嵌套循环或哈希连接的全表扫描,性能急剧下降。添加索引后,优化器通常会选择索引范围扫描。此外,对于大规模数据,可以使用 /*+ USE_NL */ 或 /*+ HASH_JOIN */ 提示来引导执行计划,但需谨慎测试。同时,确保统计信息最新,以便优化器做出正确决策。

CREATE INDEX idx_target_id ON target_table(id);
CREATE INDEX idx_source_id ON source_table(id);

-- 在存储过程中调用时使用 hint
MERGE /*+ USE_NL(t s) */ INTO target_table t
USING source_table s
ON (t.id = s.id)
WHEN MATCHED THEN
  UPDATE SET t.name = s.name
WHEN NOT MATCHED THEN
  INSERT (id, name) VALUES (s.id, s.name);
预期结果:执行计划显示使用索引扫描,而非全表扫描。执行时间显著缩短,尤其是在数据量超过百万级时。
基于 MERGE INTO 中大量 NOT MATCHED 插入时的回滚段压力问题
当 MERGE INTO 语句中包含大量 WHEN NOT MATCHED THEN INSERT 操作时,可能会产生巨大的 undo 日志,导致回滚段压力增大,甚至引发 ORA-30036 错误。这是因为每次插入都需要记录 undo 以支持事务回滚。解决此问题的方法是分批提交或使用 /*+ APPEND */ 提示启用直接路径加载,从而绕过缓冲区缓存并减少 undo 生成。直接路径加载适用于大批量数据插入,但不适用于需要立即查询的场景,因为数据不会立即对未提交事务可见。


