






java iterator 遍历解释器模式的核心在于将遍历逻辑与数据结构解耦,通过实现 java.util.iterator 接口来暴露集合的访问方式。具体做法是创建一个内部类或独立类实现 iterator,在 next() 中返回当前元素并移动指针,在 hasnext() 中检查是否越界。这样做可以让外部代码使用标准的 for-each 循环或 while 循环统一处理集合,无需关心底层是数组、链表还是树结构。
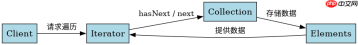
如何为自定义集合实现 Iterator 接口
要实现一个可遍历的自定义集合,需要定义一个实现了 Iterator 接口的内部类。该类必须维护一个索引指针,并在 next() 方法中抛出 ConcurrentModificationException 以防止并发修改(可选但推荐),同时确保 remove() 方法有基本实现。主集合类需重写 iterator() 方法返回该迭代器实例。这样用户即可通过增强 for 循环直接遍历该集合对象。
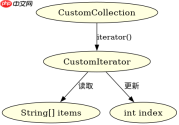
import java.util.Iterator;
import java.util.NoSuchElementException;

public class CustomCollection {
    private String[] items = {"A", "B", "C"};

    public Iterator<string> iterator() {
        return new CustomIterator();
    }

    private class CustomIterator implements Iterator<string> {
        private int index = 0;

        @Override
        public boolean hasNext() {
            return index </string></string>
解释器模式中 Iterator 如何配合 Context 使用
在解释器模式中,如果上下文(Context)包含一组需要按特定顺序处理的表达式节点,可以使用 Iterator 来管理这些节点的遍历。通常,解释器会递归处理单个表达式,但当需要批量处理一组语句时,Iterator 提供了统一的访问入口。Context 持有这组表达式的集合,并通过 Iterator 逐个获取表达式交给具体的 Interpreter 实现类执行。这种方式避免了在 Context 中硬编码遍历逻辑,提高了扩展性。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。

import java.util.ArrayList;
import java.util.List;
import java.util.Iterator;

interface Expression {
    void interpret(Context context);
}

class Context {
    private List<expression> expressions = new ArrayList();

    public void addExpression(Expression expr) {
        expressions.add(expr);
    }

    public void processAll() {
        Iterator<expression> it = expressions.iterator();
        while (it.hasNext()) {
            it.next().interpret(this);
        }
    }
}</expression></expression>
Iterator 在解释器批量处理中的异常处理机制
当使用 Iterator 遍历解释器模式中的表达式列表时,如果在遍历过程中某个表达式抛出运行时异常,Iterator 本身不会捕获该异常,而是将其向上传播。这意味着调用者必须在 processAll() 外部使用 try-catch 块包裹遍历逻辑,或者在具体的 interpret() 实现中进行局部异常处理。此外,如果在遍历过程中修改了底层的 expressions 列表(例如添加或删除元素),除非使用了 fail-fast 机制,否则可能引发 ConcurrentModificationException 或导致跳过/重复处理元素。因此,在解释器模式中,通常建议在遍历前克隆列表或在非并发环境下谨慎操作。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


