






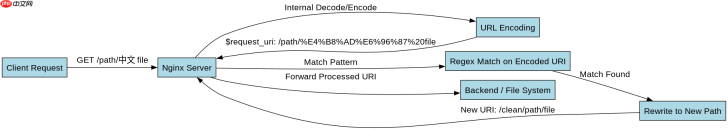
nginx 中处理带有空格和中文的路径重写,核心在于确保请求 uri 在传递给 rewrite 规则前已被正确解码。默认情况下,nginx 会将 url 中的特殊字符(如空格、中文)保留为百分号编码形式(例如 %20 或 %e4%b8%ad%e6%96%87),因此正则表达式必须匹配这些编码后的字符串,而不是原始字符。若需直接操作原始路径,可借助 $uri 变量配合 try_files 或第三方模块,但标准做法是在正则中显式写出编码序列或使用通配符兼容两种状态。
如何匹配百分号编码后的中文与空格?
要匹配经过 URL 编码的路径,必须在正则表达式中直接使用对应的十六进制编码序列。例如,空格通常编码为 %20,而中文字符则根据其 UTF-8 字节序列进行编码。Nginx 的 rewrite 指令在处理 $request_uri 时,看到的是编码后的版本,因此正则需针对编码后内容编写。
server {
    listen 80;
    server_name example.com;

    # 示例:将包含中文“测试”和空格的请求重写到 /clean/path
    # “测”的UTF-8编码为 E6 B5 8B,“试”为 E8 AF 95
    # 空格编码为 20
    rewrite ^/path/%E6%B5%8B%E8%AF%95%20file$ /clean/path/file last;

    location /clean/ {
        root /var/www/html;
    }
}
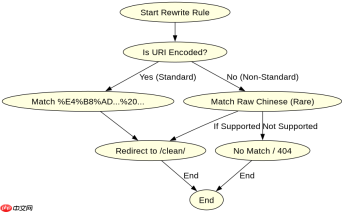
上述配置中,rewrite 规则精确匹配了编码后的中文和空格。如果用户访问的是未编码的原始路径(某些浏览器或客户端可能发送未编码请求,尽管不符合 RFC 标准),此规则将失效。为确保兼容性,通常建议在前端或网关层统一编码,或在 Nginx 中使用更通用的匹配策略。
如何同时兼容编码与非编码的请求?
为了同时处理已编码和未编码(或混合编码)的请求,可以使用正则表达式的通配符或字符类来模糊匹配。由于 Nginx 的正则引擎不支持直接匹配“原始中文”,最佳实践是分别定义针对常见编码模式的规则,或者使用 if 结合 $uri 变量进行判断。然而,if 指令在 Nginx 中需谨慎使用,因为它会引入新的上下文并可能导致性能问题。更稳健的方法是使用 map 指令预处理 URI,或直接接受编码格式作为标准输入。


server {
    listen 80;
    server_name example.com;

    # 方法:使用两个 rewrite 规则覆盖主要场景
    # 1. 匹配编码后的中文和空格
    rewrite ^/api/%E4%B8%AD%E6%96%87%20data$ /api/data processed last;

    # 2. 匹配未编码的中文(如果客户端发送未编码请求)
    # 注意:Nginx 内部通常已将非 ASCII 字符编码,此规则可能无法命中
    # 除非使用特定模块或配置调整
    rewrite ^/api/[\x{4e00}-\x{9fa5}]+\s+data$ /api/data processed last;

    location /api/ {
        root /var/www/html;
        # 处理逻辑
    }
}
在实际部署中,强烈建议统一要求客户端发送符合 RFC 3986 标准的百分号编码 URI。Nginx 原生对非 ASCII 字符的处理依赖于其内部的编码转换机制,通常会将所有非 ASCII 字符转换为 UTF-8 字节序列的百分号编码。因此,编写针对编码后字符串的正则是最可靠的方式。对于动态生成的路径,建议在应用层完成编码后再发起请求,避免在 Nginx 层进行复杂的解码和重匹配。
当 rewrite 目标路径包含中文时会发生什么?
当 rewrite 指令的目标路径(即重写后的新路径)中包含中文字符时,Nginx 的行为取决于具体的上下文和后续处理模块。通常情况下,rewrite 的结果会被视为一个新的 URI,并继续在内部分配器中查找。如果该路径对应于文件系统上的实际文件,且文件系统支持 UTF-8 文件名,Nginx 可能会尝试直接访问该文件。然而,许多 Web 服务器和应用程序期望 URI 是百分号编码的。如果目标路径未编码,可能会导致 404 错误,因为内部查找可能无法正确匹配未编码的文件名。此外,响应头中的 Location 字段如果包含未编码的中文字符,某些客户端可能会解析失败。因此,最佳实践是确保 rewrite 的目标路径也是百分号编码的,或者使用 return 指令配合编码后的 URL,以确保整个流程的一致性。


