openai于11月18日说明前沿模型风险管理方法,将对齐、安全、阻断性防护以及监测响应四层控制贯穿研究、内部使用和外部部署。不同阶段获得的工具和系统权限不同,因此控制组合也不同;公司没有把单一沙箱或模型自身拒绝回答视为完整保障。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
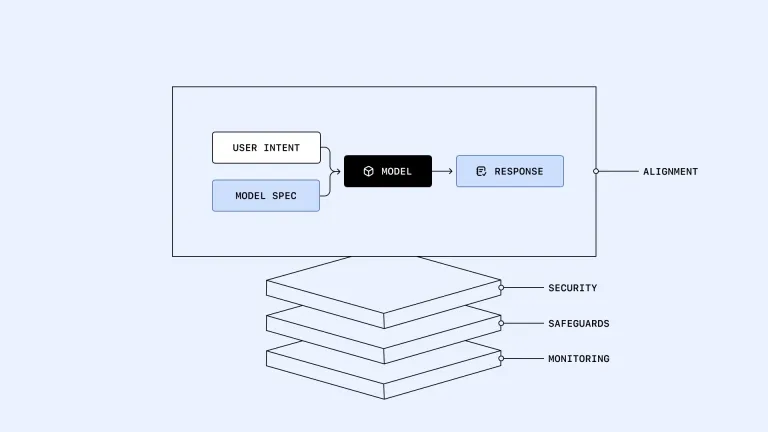
图示分别连接用户意图、模型行为、安全边界、防护和监测。
研究环境与内部系统采用不同边界
研究阶段更依赖隔离、网络边界和监测;模型获得更广泛的内部访问能力时,还要考虑对齐、可监测性与自动审核。外部部署则增加滥用检测、第三方及适应性红队等措施。评估结果可能提交安全咨询机制审查,发现风险后还需要调查和干预。
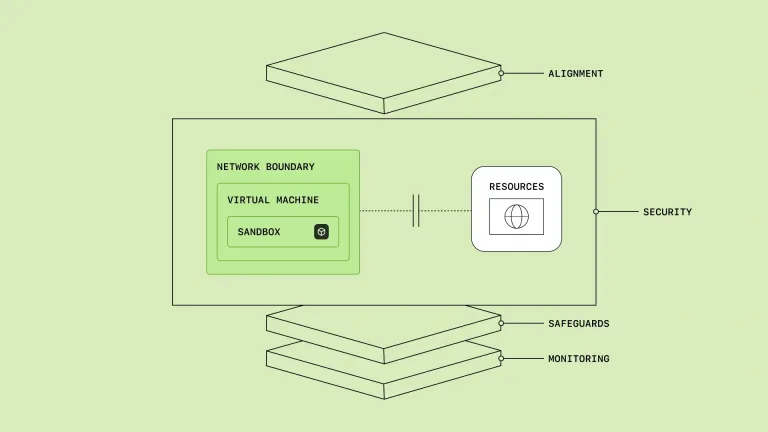
官方示意图展示隔离层次,不是对任意实际部署的安全保证。
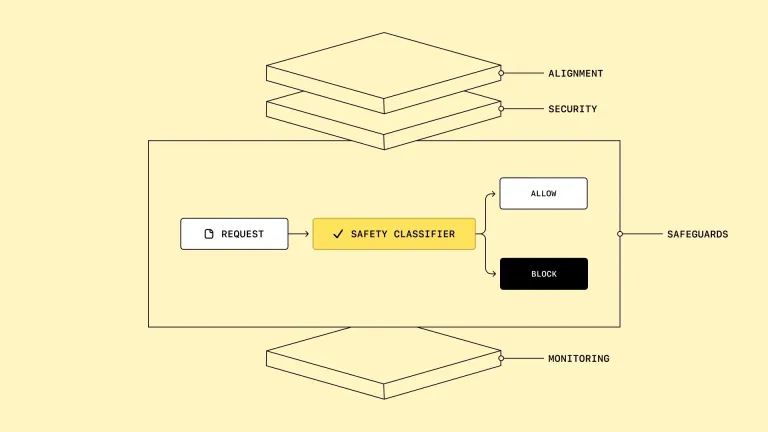
安全分类器可允许或阻断请求,与环境隔离属于不同控制层。
停止推理输出不等于所有工作负载立即退出
原文介绍ControlRoom在收到停止指令后35秒内阻止进一步模型输出,但已启动的研究工作负载可能仍在运行。因此停止模型推理和停止其派生进程必须分别看待。原文回顾的DNS相关事件发生于9月20日至10月1日,并已在10月23日披露,不是11月18日首次公开的新事故。

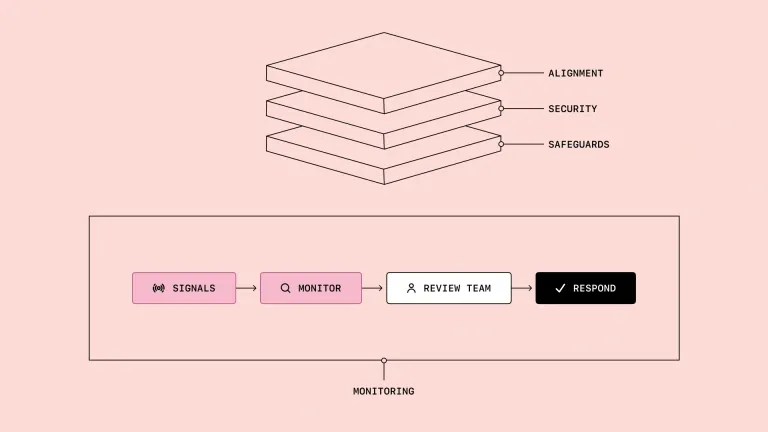
信号进入监测和审查,再触发响应;这与预先阻断不是同一步。