用codex制作风格统一的系列视频,可以先安装table-video skill,把文稿、配音和参考交给它,再依次确认风格、分段和镜头,制作首版后人工审片返修。这个流程适合以配音推进的知识讲解、产品演示等视频,需要能读写本地项目的agent和人工审片;生图、生视频素材仍需按提示生成并回传,不能把渲染完成当作成片已经合格。
把Skill装进项目,交代本期素材
打开Codex中的目标项目,让Agent安装下面的Skill;手动安装时,把仓库里的skills/table-video整个文件夹放进项目的.agents/skills/,保留文件夹内部结构。
帮我安装这个 Skill:https://github.com/duoduoler-ops/Table-VideoSOP/tree/main/skills/table-video
准备文稿路径、已有配音和参考图片或视频。没有配音、没有参考时直接说明,不要用不存在的路径占位。开始制作时可按下面的格式填写自己的材料:
用 table-video Skill 做这期视频。
文稿:[实际路径];配音:[实际路径/还没有];参考:[实际路径或链接/没有]。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
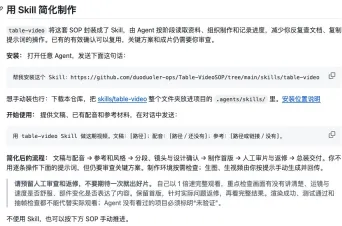
Table-VideoSOP项目文档,CC BY 4.0。
先确认静态外观,再确认运动方式
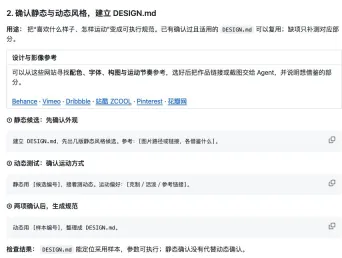
先提供喜欢的配色、字体、构图参考,并说明分别借鉴什么。让Agent给出静态风格候选,选定后继续看动态样本,确认运动速度、转场和节奏。两项都认可后,再整理为DESIGN.md,后续各集使用同一份规范作为起点。
已有规范时,先检查本期是否适用;需要调整的部分单独确认。只认可一张静态图,还不足以确定视频里的运镜和变化方式。

通过 Telegram 命令管理 OpenAI Codex 配置文件,支持用量查询与 OAuth Token 刷新,并提供队列化安全应用(queued safe apply)及进度更新。
Table-VideoSOP项目文档,CC BY 4.0。
把文稿分成制作段,逐段确认画面看点
以文稿和配音为依据划分大段,先确认每段讲什么、用什么画面路线,再细化镜头。每段写出一句明确看点,并让画面承担解释作用:哪件事发生变化、观众该看哪里、这一段与前后段怎样衔接。
先看完整的动作和表达过程,再精修参数。新类型或返工风险较高的段落,先用带配音的预演确认难点;已经确认且适用的做法可以复用,避免所有镜头反复从零试起。
首版保留原样,用实际问题推动返修
首版出来后,按正常速度完整观看。记录画面没讲清的地方、阅读停顿不足的位置、运动过快或过慢的片段,把问题定位到具体镜头后再返修。抽帧和自动检查可以辅助查错,不能替代整段观看。
交付后把返工原因分开记录:规则没有写、写了没有执行、规则本身导向有误,还是当时判断失误。同时保存满意片段作为后续参考,只修改已经确认需要调整的规范。模型执行能力和素材复杂度会影响迭代次数,应给首版和返修都留出时间。
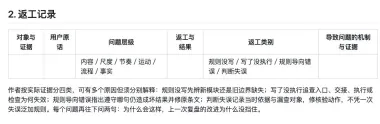
Table-VideoSOP项目文档,CC BY 4.0。