






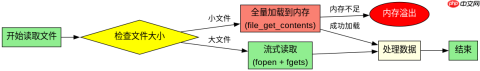
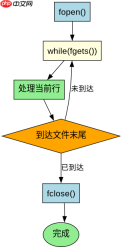
php读取大文件时内存溢出可以通过使用流式处理(streaming)或逐行读取来解决,避免一次性将全部文件内容加载到内存中。具体做法是调用 fopen() 打开文件句柄,然后结合 fgets() 或 splfileobject 在循环中每次只读取一行或固定大小的数据块进行处理。这样无论文件多大,内存占用始终保持在极低的水平,因为数据在处理完并释放后不会被累积保留。
fread() 与 file_get_contents() 的内存差异是什么
这两个函数都会尝试将整个文件内容读入内存,导致大文件场景下内存溢出。区别在于 file_get_contents() 是更高层的封装,而 fread() 需要配合文件指针手动控制读取长度,但两者默认行为都是全量加载。要解决此问题,必须放弃这些全量读取函数,改用基于文件句柄的流式接口。
$handle = fopen("large_file.csv", "r");
if ($handle) {
    while (($line = fgets($handle)) !== false) {
        // 处理每一行数据
        processLine($line);
    }
    fclose($handle);
} else {
    echo "无法打开文件";
}
上述代码展示了使用 fopen 和 fgets 的标准模式。预期结果是程序能够稳定运行,内存峰值仅取决于单行数据的长度,而非整个文件大小。如果文件很大,这种方式的内存消耗几乎可以忽略不计。
如何使用 SplFileObject 简化大文件遍历
SplFileObject 是 PHP 提供的面向对象的文件操作类,它内部已经实现了迭代器协议,使得遍历大文件更加简洁和安全。它支持自动跳过空行、设置最大内存限制以及处理 CSV 等特殊格式,比原生的 fgetcsv 等函数更易用且不易出错。

使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。

$file = new SplFileObject("large_file.csv");
$file->setFlags(SplFileObject::SKIP_EMPTY | SplFileObject::DROP_NEW_LINE);
foreach ($file as $lineNumber => $line) {
    // 处理每一行
    echo "Line {$lineNumber}: {$line}";
}
这段代码利用 SplFileObject 的迭代特性,无需手动管理文件指针。预期输出是按行打印文件内容,且内存占用恒定。通过设置标志位,可以进一步过滤无效数据,提高处理效率。
当文件包含特殊编码或换行符时如何处理
在处理大文件时,如果遇到非标准换行符(如 Windows 的 CRLF 与 Linux 的 LF 混用)或特殊编码(如 UTF-8 BOM),直接使用 fgets() 可能导致解析错误。此时需要在读取前对文件进行预处理,或在读取后对每行数据进行清洗。例如,可以使用 trim() 去除末尾换行符,或使用 mb_detect_encoding() 检测并转换编码。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





