






java 编译中文乱码通常是因为 javac 默认编码与源文件编码不一致,解决方法是在编译时显式指定 -encoding utf-8 参数。这样能确保编译器正确读取源代码中的中文字符并生成对应的字节码,从而解决乱码问题。

为什么 javac 会忽略系统默认编码?
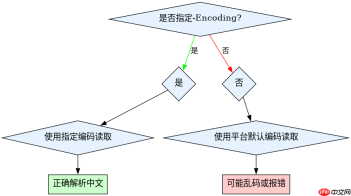
因为 Java 编译器在启动时如果没有通过 -encoding 明确指定字符集,它会使用平台默认的字符集(如 Windows 上的 GBK)来读取 .java 文件。如果源文件实际保存为 UTF-8 格式,而编译器按 GBK 解析,就会导致乱码或编译错误。因此,必须强制指定编码以匹配文件实际存储格式。
javac -encoding UTF-8 Test.java
java Test
运行上述命令后,控制台将正确输出源代码中的中文内容。若未加 -encoding UTF-8,且系统默认编码非 UTF-8,则可能出现乱码。
如何在 IDE 中避免手动设置编码?
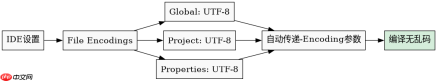
在 IntelliJ IDEA 或 Eclipse 等主流 IDE 中,可以通过全局设置统一项目编码,避免每次编译都手动添加参数。例如在 IDEA 中,进入 Settings -> Editor -> File Encodings,将 Global Encoding、Project Encoding 和 Default encoding for properties files 均设为 UTF-8。这样 IDE 会自动调用带 -encoding UTF-8 的 javac 命令,无需用户干预。

// 示例代码:Test.java
public class Test {
    public static void main(String[] args) {
        System.out.println("你好,世界!");
    }
}
该代码在任何支持 UTF-8 的环境中均可正常编译和运行。关键在于确保文件保存编码与编译器读取编码一致。
当源文件包含特殊 Unicode 字符时如何处理?
若源文件中包含非 ASCII 字符(如 emoji 或生僻汉字),仍需确保文件以 UTF-8 保存,并在编译时使用 -encoding UTF-8。否则,即使系统默认编码支持部分 Unicode,也可能因截断或误译导致乱码。建议所有新项目统一采用 UTF-8 作为唯一编码标准,从源头杜绝兼容性问题。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南



