






在java中,可以通过将`zipinputstream`的遍历逻辑封装为自定义函数式接口,或者使用第三方库(如apache commons compress)来利用lambda表达式简化代码。由于标准库的`zipinputstream`基于迭代器模式且状态可变,直接应用stream api较复杂,推荐的做法是编写一个辅助方法将条目流式化,从而在遍历时使用lambda处理每个条目。

如何将ZipInputStream转换为Stream
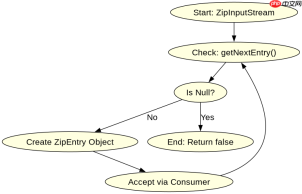
要使用Lambda表达式处理ZIP条目,核心是将传统的`while((entry = stream.getNextEntry()) != null)`循环重构为一个返回`Stream
import java.io.*;
import java.util.stream.Stream;
import java.util.zip.ZipEntry;
import java.util.zip.ZipInputStream;

public class ZipStreamUtil {
    public static Stream<zipentry> streamEntries(InputStream zipStream) {
        return StreamSupport.stream(new ZipSpliterator(zipStream), false);
    }
}

class ZipSpliterator implements Spliterator<zipentry> {
    private final ZipInputStream zis;
    private ZipEntry currentEntry;

    public ZipSpliterator(ZipInputStream zis) {
        this.zis = zis;
    }

    @Override
    public boolean tryAdvance(Consumer super ZipEntry> action) {
        try {
            currentEntry = zis.getNextEntry();
            if (currentEntry == null) {
                return false;
            }
            action.accept(currentEntry);
            return true;
        } catch (IOException e) {
            throw new UncheckedIOException(e);
        }
    }

    @Override
    public Spliterator<zipentry> trySplit() {
        return null; // ZIP entries are sequential
    }

    @Override
    public long estimateSize() {
        return Long.MAX_VALUE;
    }

    @Override
    public int characteristics() {
        return NONNULL | ORDERED;
    }
}</zipentry></zipentry></zipentry>
上述代码定义了一个`ZipSpliterator`,它实现了`Spliterator`接口,能够逐个从`ZipInputStream`中获取`ZipEntry`。通过`StreamSupport.stream`,我们可以将这个迭代过程转化为标准的Java Stream。使用时,只需传入`ZipInputStream`,即可调用`.forEach(entry -> ...)`等Lambda操作。
如何使用Lambda提取ZIP中的文本内容
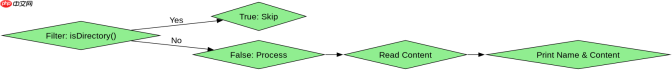
在获得`Stream

import java.io.*;
import java.util.stream.Stream;
import java.util.zip.ZipEntry;
import java.util.zip.ZipInputStream;
import java.nio.charset.StandardCharsets;

public class ZipTextExtractor {
    public static void extractText(String zipPath) throws IOException {
        try (InputStream fis = new FileInputStream(zipPath);
             ZipInputStream zis = new ZipInputStream(fis)) {

            Stream<zipentry> entryStream = StreamSupport.stream(
                new ZipSpliterator(zis), false);

            entryStream.filter(entry -> !entry.isDirectory())
                       .forEach(entry -> {
                           try (Reader reader = new BufferedReader(
                               new InputStreamReader(zis, StandardCharsets.UTF_8))) {
                               StringBuilder content = new StringBuilder();
                               char[] buffer = new char[1024];
                               int len;
                               while ((len = reader.read(buffer)) != -1) {
                                   content.append(buffer, 0, len);
                               }
                               System.out.println("File: " + entry.getName());
                               System.out.println("Content: " + content.toString());
                           } catch (IOException e) {
                               e.printStackTrace();
                           }
                       });
        }
    }
}</zipentry>
在这个示例中,`filter`操作用于排除目录条目,`forEach`则接收每个非目录条目。对于每个条目,我们创建一个新的`InputStream`(由`zis`提供)并包装为`Reader`,然后读取全部内容。注意,每次调用`getNextEntry()`后,后续的读取操作都是针对该新条目的数据流,因此不需要显式关闭`zis`内部的流,但需要确保在Lambda内部正确处理资源释放。
当ZipEntry名称包含特殊字符时如何处理
在处理ZIP条目时,如果文件名包含非ASCII字符(如中文),直接使用`entry.getName()`可能会得到乱码或错误的路径。这是因为`ZipInputStream`默认使用平台编码或UTF-8以外的编码。为确保正确性,应在创建`ZipInputStream`时指定正确的编码,或在读取文件名时使用`StandardCharsets.UTF_8`进行解码。
import java.io.*;
import java.util.zip.ZipEntry;
import java.util.zip.ZipInputStream;
import java.nio.charset.StandardCharsets;

public class ZipSpecialCharHandler {
    public static void processWithEncoding(String zipPath) throws IOException {
        try (InputStream fis = new FileInputStream(zipPath);
             ZipInputStream zis = new ZipInputStream(fis, StandardCharsets.UTF_8)) {

            ZipEntry entry;
            while ((entry = zis.getNextEntry()) != null) {
                String name = entry.getName();
                System.out.println("Processing: " + name);
                // 处理条目...
                zis.closeEntry();
            }
        }
    }
}
在上述代码中,`new ZipInputStream(fis, StandardCharsets.UTF_8)`明确指定了UTF-8编码,这能确保大多数现代ZIP工具生成的包含中文的文件名被正确解析。如果不指定编码,某些系统可能回退到GBK或其他本地编码,导致乱码。此外,`closeEntry()`必须在处理完每个条目的数据后调用,否则下一个`getNextEntry()`可能无法正确识别新的条目边界。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


