






php 8.6把mb_ereg()、mb_split()等mbregex函数列为弃用,多数utf-8文本匹配可迁移到带u修饰符的pcre函数,但必须重新核对模式语法、编码和返回值。弃用的是mbregex这一组接口,不是整个mbstring扩展;mb_strlen()等其他功能不能据此判断为被移除。
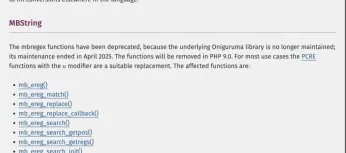
官方建议多数场景使用带u修饰符的PCRE,并列出受影响函数。
为新的模式显式加分隔符和u
<?php declare(strict_types=1);

function validDisplayName(string $text): bool
{
    // 2到20个Unicode字母、组合标记或数字;不是字素簇长度限制。
    $matched = preg_match('/\A[\p{L}\p{M}\p{N}]{2,20}\z/u', $text);
    if ($matched === false) {
        throw new RuntimeException('正则执行失败:' . preg_last_error_msg());
    }
    return $matched === 1;
}

foreach (['张三', 'Alice8', 'A', '张 三'] as $name) {
    printf("%s: %s\n", $name, validDisplayName($name) ? '通过' : '不通过');
}
文件和输入均使用UTF-8时,前两个示例通过,后两个不通过。这里的2至20限制按正则匹配的代码点计算,不等同于用户看见的字符簇数量;如果产品按显示字符计数,应单独设计字素长度规则。PCRE模式需要分隔符,不能只把mb_ereg改名后照搬原参数。
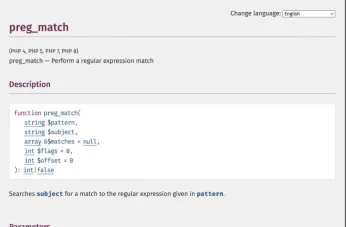
preg_match的返回类型是int或false,需要区分未匹配与执行失败。
把0和false分成两条分支
preg_match()返回1表示匹配,0表示未匹配,false表示执行失败。带u时遇到无效UTF-8输入可能返回false,因此不能用宽松判断把错误当成正常不通过。需要把其他编码转换为UTF-8的场景,应根据已知来源编码先转换,再匹配,不能猜编码后丢弃非法字节。

使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
逐条迁移替换和拆分规则
mb_ereg_replace与preg_replace、mb_split与preg_split在分隔符、捕获组、标志和返回结构上存在差异。先记录旧模式的输入输出样本,覆盖中文、组合字符、空串和异常编码,再改写对应规则;不要承诺一条通用替换适用于全部模式。现有mb_regex_encoding()设置也不会自动给PCRE模式附加u,需要逐条检查。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





