






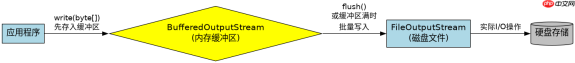
在 java 中,使用 bufferedoutputstream 的核心做法是将其包裹在目标字节流(如 fileoutputstream)外部,通过内部缓冲区减少磁盘 i/o 次数。只需实例化时传入底层流并指定缓冲区大小,调用 write() 写入数据后,务必在关闭流或程序结束前调用 flush() 强制将缓冲区内容刷入磁盘,以确保数据持久化。
如何正确初始化 BufferedOutputStream 并处理异常?
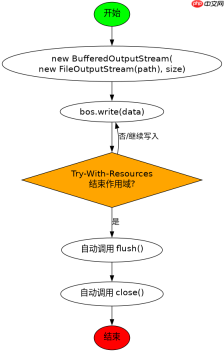
初始化 BufferedOutputStream 时,必须传入一个实现了 OutputStream 接口的对象作为装饰目标。推荐使用 try-with-resources 语法自动管理资源,避免手动关闭导致的内存泄漏或数据丢失。若未显式指定缓冲区大小,系统默认分配 8192 字节的缓冲数组;显式指定可针对大文件写入优化性能。
import java.io.BufferedOutputStream;
import java.io.FileOutputStream;
import java.io.IOException;

public class BufferDemo {
    public static void main(String[] args) {
        // 定义目标文件路径
        String filePath = "output.txt";
        // 尝试使用 try-with-resources 自动关闭流
        try (BufferedOutputStream bos = new BufferedOutputStream(
                new FileOutputStream(filePath), 4096)) {
            // 写入字符串的字节数据
            byte[] data = "Hello Buffered Stream".getBytes();
            bos.write(data);
            // 注意:try-with-resources 会在块结束时自动调用 flush() 和 close()
        } catch (IOException e) {
            System.err.println("写入失败: " + e.getMessage());
        }
    }
}
上述代码创建了一个 4KB 缓冲区的输出流。当 write() 被调用时,数据首先存入内存中的缓冲区。当缓冲区满或流被关闭时,数据才会批量写入磁盘。这种机制显著提升了频繁小量写入的性能。
为什么必须显式调用 flush() 或在关闭时刷新?
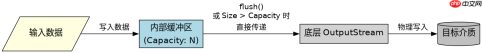
BufferedOutputStream 的设计初衷是“缓冲”,这意味着数据不会立即写入底层设备。如果程序在缓冲区未满时意外终止(如崩溃或未捕获异常),或者开发者忘记关闭流,缓冲区内的数据将永久丢失。因此,理解 flush() 的作用至关重要,它强制清空缓冲区,将所有已写入但未落盘的数据推送到目标流中。

import java.io.BufferedOutputStream;
import java.io.FileOutputStream;
import java.io.IOException;

public class FlushDemo {
    public static void main(String[] args) {
        String filePath = "flush_test.txt";
        try (BufferedOutputStream bos = new BufferedOutputStream(
                new FileOutputStream(filePath))) {

            bos.write('A'); // 仅写入1个字节,远小于默认8192缓冲区

            // 此时数据仍在内存缓冲区中,未写入磁盘
            // 如果在此处检查文件大小,可能为0

            // 显式刷新,确保数据落盘
            bos.flush();

            // 后续写入...
            bos.write('B'.getBytes());

        } catch (IOException e) {
            e.printStackTrace();
        }
        // 离开 try 块时,close() 会自动调用 flush()
    }
}
在上面的示例中,写入单个字符 'A' 后,由于未达到阈值,数据暂存于内存。调用 flush() 后,该字节被强制写入文件。这验证了缓冲机制对即时性的影响。对于需要实时同步数据的场景,应谨慎权衡缓冲带来的性能提升与延迟风险。
缓冲区满时 BufferedOutputStream 的具体行为是什么?
当向 BufferedOutputStream 写入的数据量超过其内部缓冲区容量时,流会自动触发“刷新”操作。具体而言,它会先将缓冲区中已有的数据全部写入底层流,然后对于超出部分的大数据块,通常有两种处理方式:一是直接绕过缓冲区写入底层流(取决于实现),二是扩容或分块写入。以 JDK 标准实现为例,若单次写入长度大于缓冲区大小,数据会直接传递给底层流,不再经过缓冲,以避免在大对象拷贝上浪费内存。
import java.io.BufferedOutputStream;
import java.io.FileOutputStream;
import java.io.IOException;

public class LargeWriteDemo {
    public static void main(String[] args) {
        String filePath = "large_write.bin";
        try (BufferedOutputStream bos = new BufferedOutputStream(
                new FileOutputStream(filePath), 1024)) { // 设置较小缓冲区 1KB

            // 创建一个比缓冲区大的字节数组
            byte[] largeData = new byte[2048];
            for(int i=0; i<largedata.length i largedata bos.write catch e e.printstacktrace><p>此代码展示了当写入 2048 字节而缓冲区仅为 1024 字节时的行为。JDK 源码逻辑会检测到写入长度大于缓冲区长度,从而直接将整个数组传递给底层的 <code>FileOutputStream</code>,跳过缓冲步骤。这保证了大文件写入的效率,避免了在堆内存中复制大块数据。开发者无需手动处理这种情况,库已优化完毕。</p></largedata.length>
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


