






java 对象序列化性能优化主要依赖减少反射开销、复用缓冲区以及使用更高效的二进制格式。具体做法包括:将 `objectoutputstream` 与 `bytearrayoutputstream` 或文件流结合,避免频繁创建新流;对大型集合使用批量写入而非逐个序列化;对于高频场景,考虑切换到 kryo、fst 或 protobuf 等替代方案,它们通过预编译 schema 或缓存类元数据显著降低 cpu 和内存开销。若必须使用 jdk 原生序列化,可通过实现 `writereplace` 方法替换为轻量级代理对象,从而减少序列化的字段数量。

JDK 原生序列化如何减少 I/O 开销
在使用 JDK 原生 `java.io.Serializable` 时,最大的性能瓶颈通常来自频繁的 I/O 操作和对象头的重复写入。优化核心在于复用底层缓冲区和启用写缓存。通过包装 `BufferedOutputStream` 或使用 `ByteArrayOutputStream` 并在最后一次性获取字节数组,可以大幅减少系统调用次数。此外,确保序列化流被正确关闭或利用 try-with-resources 语法,能防止资源泄漏导致的性能退化。
import java.io.*;
import java.util.Arrays;

public class SerializationOptimization {
    public static void main(String[] args) throws Exception {
        // 模拟大数据量对象
        byte[] data = new byte[1024 * 1024]; // 1MB
        Arrays.fill(data, (byte) 1);
        Payload payload = new Payload(data);

        // 优化前:每次序列化都创建新流(伪代码逻辑)
        // long start = System.currentTimeMillis();
        // for(int i=0; i
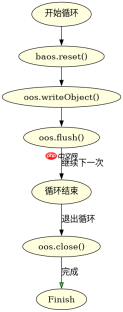
<p>上述代码展示了如何通过 `baos.reset()` 复用缓冲区,以及保持 `ObjectOutputStream` 实例存活来消除重复初始化对象的开销。预期结果是多次序列化操作的总耗时显著低于每次新建流的方案。需要注意的是,`ObjectOutputStream` 内部也有缓存机制,复用它能进一步利用已加载的类描述信息。</p>
<h2>如何替换 JDK 序列化以降低 CPU 开销</h2><p>JDK 原生序列化严重依赖反射来读取字段值并写入对象图,这导致较高的 CPU 消耗。优化方向是使用第三方库如 Kryo 或 FST,它们通过代码生成或字节码增强技术,直接访问字段而绕过反射。以 Kryo 为例,注册类并复用 `Kryo` 和 `Output` 实例是标准做法。相比 JDK 序列化,Kryo 生成的二进制格式更紧凑,且序列化速度通常快数倍。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill13354" title="JavaScript规范工具(免费版)"><img
														src="https://img.php.cn/upload/skill/001/246/273/6adaf20dbae7c507.jpg" alt="JavaScript规范工具(免费版)" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill13354" title="JavaScript规范工具(免费版)" class="overflowclass">JavaScript规范工具(免费版)</a>
													<p class="overflowclass">面向个人开发者的JavaScript代码风格指南,涵盖核心规则与基础代码审查能力。</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill13354" title="JavaScript规范工具(免费版)" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div><p>@@##@@</p>
<pre class="brush:php;toolbar:false;">import com.esotericsoftware.kryo.Kryo;
import com.esotericsoftware.kryo.io.Input;
import com.esotericsoftware.kryo.io.Output;
import java.nio.ByteBuffer;

public class KryoOptimization {
    public static void main(String[] args) {
        Kryo kryo = new Kryo();
        kryo.register(Payload.class);

        Output output = new Output(1024, -1); // 初始容量,自动扩容
        Input input = new Input(ByteBuffer.allocateDirect(1024 * 1024));

        Payload payload = new Payload(new byte[1024]);

        long start = System.currentTimeMillis();
        for (int i = 0; i
<p>Kryo 示例中,`output.clear()` 用于清空缓冲区以便复用,`kryo.register()` 提前注册类以避免运行时类型查找。这种模式消除了反射开销,并提供了更紧凑的二进制编码。预期结果是在相同硬件下,Kryo 的序列化/反序列化速度远快于 JDK 原生方式,且生成的字节数组体积更小。</p>
<h2>基于 Payload 类中 byte[] 字段的序列化影响</h2><p>在 `Payload` 类中包含一个大的 `byte[]` 字段时,序列化性能主要受该数组大小和 JVM 堆内存管理的影响。JDK 序列化会将整个数组内容复制到输出缓冲区,如果数组极大,可能导致 `OutOfMemoryError` 或 GC 停顿。优化策略是实现 `Externalizable` 接口,手动控制大数组的读写,或者使用 NIO 的 `ByteBuffer` 直接传递引用(在特定框架支持下)。在 Kryo 中,默认行为也是复制,但可以通过配置 `InstantiatorStrategy` 来优化对象创建。</p>

Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南



