






使用 forkjoinpool 分治任务的核心做法是继承 forkjointask(通常用 recursiveaction 处理无返回值或 recursivetask 处理有返回值),重写 compute() 方法,在方法内判断任务规模是否小于阈值,若大于阈值则拆分为子任务并调用 fork() 提交,再调用 join() 等待结果合并;若小于阈值则直接执行。这样能利用工作窃取算法自动平衡线程负载。

ForkJoinPool 的默认并行度如何确定
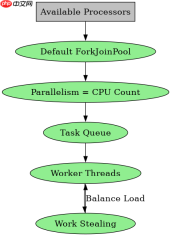
默认情况下,ForkJoinPool 的并行度等于当前机器的可用处理器数量,即 Runtime.getRuntime().availableProcessors()。这意味着如果你不指定参数,它会自动创建与 CPU 核心数相同的线程数来执行任务。这个设计是为了最大化 CPU 利用率,避免过多的上下文切换开销。你可以通过构造函数传入自定义的并行度,或者使用静态工厂方法 ForkJoinPool.commonPool() 获取共享池,但要注意共享池的任务可能会与其他应用逻辑竞争资源。
import java.util.concurrent.ForkJoinPool;
import java.util.concurrent.RecursiveAction;

public class Main {
    public static void main(String[] args) {
        int[] data = new int[1000];
        for (int i = 0; i <p>运行上述代码,你会看到控制台输出多个线程处理的区间,且并行度默认为你的 CPU 核心数。例如在 8 核机器上,并行度通常为 8。每个子任务在达到阈值时由当前线程直接执行,否则继续拆分并由工作窃取机制调度。</p><h2>如何手动控制 <code>ForkJoinPool</code> 的并行度</h2><p>要手动控制并行度,需要在实例化 <code>ForkJoinPool</code> 时通过构造函数传入 <code>parallelism</code> 参数。这适用于你需要限制并发资源以保护系统稳定性,或者在特定场景下优化吞吐量的情况。例如,你可以设置并行度为 4,即使机器有 16 个核心,也只会使用 4 个线程进行分治计算。此外,还可以使用 <code>ForkJoinPool</code> 的其他配置选项,如队列容量和异常处理策略,但并行度是最关键的参数。注意,修改并行度不会影响已提交的任务,只影响后续新任务的调度。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill13354" title="JavaScript规范工具(免费版)"><img
														src="https://img.php.cn/upload/skill/001/246/273/6adaf20dbae7c507.jpg" alt="JavaScript规范工具(免费版)" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill13354" title="JavaScript规范工具(免费版)" class="overflowclass">JavaScript规范工具(免费版)</a>
													<p class="overflowclass">面向个人开发者的JavaScript代码风格指南,涵盖核心规则与基础代码审查能力。</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill13354" title="JavaScript规范工具(免费版)" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div><p><img src="https://img.php.cn/upload/article/001/242/473/179497450333712.png?x-oss-process=image/resize,p_40" alt="Java 线程池怎么用 ForkJoinPool 分治任务"></p><pre class="brush:php;toolbar:false;">import java.util.concurrent.ForkJoinPool;
import java.util.concurrent.RecursiveTask;

public class MainWithCustomPool {
    public static void main(String[] args) {
        int[] data = new int[1000];
        for (int i = 0; i  {
    private final int[] data;
    private final int start;
    private final int end;
    private static final int THRESHOLD = 100;

    public MaxValueTask(int[] data, int start, int end) {
        this.data = data;
        this.start = start;
        this.end = end;
    }

    @Override
    protected Integer compute() {
        if (end - start  max) {
                    max = data[i];
                }
            }
            return max;
        } else {
            int mid = (start + end) / 2;
            MaxValueTask left = new MaxValueTask(data, start, mid);
            MaxValueTask right = new MaxValueTask(data, mid, end);
            left.fork();
            Integer rightResult = right.compute(); // 直接计算右半部分,左半部分由 fork 调度
            Integer leftResult = left.join();     // 等待左半部分结果
            return Math.max(leftResult, rightResult);
        }
    }
}
运行此代码,你将观察到并行度被限制为 4,且任务分配遵循分治逻辑。通过比较不同并行度下的执行时间,可以验证资源限制对性能的影响。在实际应用中,建议根据任务类型和数据规模调整并行度,以达到最佳效果。
当子任务数量超过阈值时会发生什么
当子任务数量超过阈值时,ForkJoinPool 会持续递归拆分任务,直到每个子任务的规模小于预设的阈值。这个过程是动态的,每个线程在执行完自己的任务后,会尝试从其他线程的任务队列中“窃取”任务,从而平衡负载。如果所有子任务都已完成,线程将进入空闲状态,等待新任务或终止。这种机制确保了在高并发场景下,CPU 资源得到充分利用,同时避免了任务堆积导致的内存溢出或响应延迟。开发者只需关注阈值的设定,无需手动管理线程生命周期。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


