






使用数据库查询结果去重的核心做法是:在java中调用jdbc获取`resultset`后,遍历每一行数据并提取用于判重的唯一键(如id),将其作为键存入`hashset`。若`add()`方法返回`true`则说明该记录未重复,应予以保留;若返回`false`则说明已存在,直接跳过。此过程利用哈希表o(1)的查找特性,确保内存中只保留一份完整的数据对象。
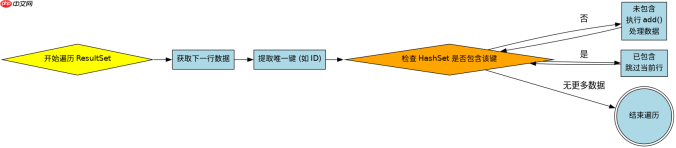
如何从 ResultSet 中提取唯一键
从数据库游标中获取唯一标识符是去重的前提。通常通过`rs.getInt("id")`或`rs.getString("uuid")`等方法读取列值。关键在于确定哪一列组合能代表“唯一性”,例如仅凭主键ID即可,或者需要结合业务字段如用户名和邮箱。获取到这些原始值后,需将其转换为适合放入集合的对象类型,通常是包装类或字符串。
import java.sql.*;
import java.util.HashSet;
import java.util.Set;

public class DbDedup {
    public static void main(String[] args) throws Exception {
        // 模拟数据库连接与查询
        String sql = "SELECT id, name FROM users";
        // 假设 getConnection() 已实现
        Connection conn = DriverManager.getConnection("jdbc:mysql://localhost/test", "user", "pass");
        Statement stmt = conn.createStatement();
        ResultSet rs = stmt.executeQuery(sql);

        Set<integer> seenIds = new HashSet();
        while (rs.next()) {
            int id = rs.getInt("id");
            if (seenIds.add(id)) {
                System.out.println("Processing unique user: " + id);
            } else {
                System.out.println("Skipping duplicate user: " + id);
            }
        }
        rs.close();
        stmt.close();
        conn.close();
    }
}</integer>
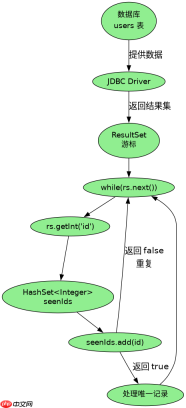
上述代码展示了标准的遍历逻辑。`seenIds.add(id)`是核心判断点。当`id`首次出现时,集合中添加成功并返回`true`,程序执行处理逻辑;当相同的`id`再次出现时,添加失败并返回`false`,程序进入跳过分支。这种模式适用于任何基于单一主键或复合键的去重场景。
如何处理复杂对象的去重
当需要根据多个字段组合进行去重,且对象本身没有合适的`hashCode`实现时,不能直接将自定义对象放入`HashSet`。此时应构建一个包含所有判重字段的辅助对象(如DTO或Record),或者使用字符串拼接生成的唯一标识符作为Set的元素。这样可以将复杂的对象比较转化为简单的值比较。


import java.sql.*;
import java.util.HashSet;
import java.util.Set;

class UserKey {
    final int id;
    final String name;
    UserKey(int id, String name) { this.id = id; this.name = name; }
    @Override public int hashCode() { return 31 * id + (name==null?0:name.hashCode()); }
    @Override public boolean equals(Object o) {
        if (this == o) return true;
        if (!(o instanceof UserKey)) return false;
        UserKey uk = (UserKey) o;
        return id == uk.id && (name!=null ? name.equals(uk.name) : uk.name==null);
    }
}

public class ComplexDedup {
    public static void main(String[] args) throws Exception {
        Connection conn = DriverManager.getConnection("jdbc:mysql://localhost/test", "user", "pass");
        Statement stmt = conn.createStatement();
        ResultSet rs = stmt.executeQuery("SELECT id, name FROM users");

        Set<userkey> uniqueUsers = new HashSet();
        while (rs.next()) {
            int id = rs.getInt("id");
            String name = rs.getString("name");
            UserKey key = new UserKey(id, name);
            if (uniqueUsers.add(key)) {
                System.out.println("Added complex user: " + name);
            }
        }
        rs.close();
        stmt.close();
        conn.close();
    }
}</userkey>
在这个示例中,`UserKey`类重写了`hashCode`和`equals`方法,确保只有当`id`和`name`都相同时才被视为重复。虽然这增加了代码量,但保证了去重的准确性。对于简单场景,也可以直接使用`id + "_" + name`作为String类型的Set元素,避免定义额外类。
如果数据库中存在完全重复的行会怎样
如果SQL查询结果中包含完全相同的行(即所有字段值一致),上述基于主键或复合键的逻辑依然有效。只要判重依据覆盖了所有导致重复的字段,`HashSet`就能正确识别并过滤掉后续出现的相同行。需要注意的是,如果不去重,内存中的列表或对象池会膨胀,增加GC压力。此外,若数据库驱动支持,也可考虑在SQL层面使用`DISTINCT`或`GROUP BY`减少网络传输和内存占用,但在Java端做去重提供了更灵活的业务控制能力。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


