






在 java 中避免中文乱码的核心做法是统一指定 utf-8 编码,确保从文件读取、网络传输到控制台输出的全链路字符集一致。具体实现时,应使用带 charset.forname("utf-8") 参数的构造函数或工具类,例如 new string(bytes, "utf-8") 或 files.readstring(path, standardcharsets.utf_8)。只要输入字节流和输出目标都明确绑定 utf-8,java 就能正确解析多字节的中文数据,从而消除因默认编码(如 windows 的 gbk)不匹配导致的乱码。

如何正确将字节数组转换为包含中文的字符串
当程序接收到原始字节数据时,必须显式指定 UTF-8 进行解码,否则 String 构造器会使用平台默认编码,导致中文变成问号或乱码。通过传入 StandardCharsets.UTF_8 常量,可以强制 JVM 按照 UTF-8 规则将每三个字节还原为一个汉字。这种转换方式适用于处理网络 Socket 接收的数据或从二进制文件中读取的内容,能确保内存中的字符串对象准确无误。
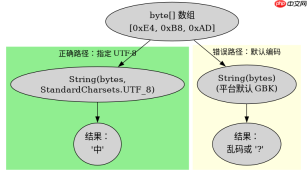
import java.nio.charset.StandardCharsets;

public class ByteToString {
    public static void main(String[] args) {
        // 模拟 UTF-8 编码的字节数组:"中" 的 UTF-8 字节为 E4 B8 AD
        byte[] bytes = new byte[] { (byte)0xE4, (byte)0xB8, (byte)0xAD };

        // 错误做法:使用平台默认编码,在 Windows 上可能产生乱码
        String wrong = new String(bytes);
        System.out.println("Default: " + wrong);

        // 正确做法:显式指定 UTF-8
        String correct = new String(bytes, StandardCharsets.UTF_8);
        System.out.println("UTF-8: " + correct);
    }
}
如何在使用 BufferedReader 时避免读取中文乱码
使用 BufferedReader 包装 InputStreamReader 时,必须在 InputStreamReader 构造函数中指定 UTF-8 编码。如果只传递 InputStream 给 BufferedReader,底层会使用平台默认编码读取字节并转换为字符,这会导致中文文本解析错误。通过显式设置编码,BufferedReader 才能正确地按行读取包含中文的文件内容,保证后续处理的准确性。


import java.io.BufferedReader;
import java.io.FileInputStream;
import java.io.InputStreamReader;
import java.nio.charset.StandardCharsets;

public class ReaderExample {
    public static void main(String[] args) throws Exception {
        // 假设有一个包含中文的 UTF-8 文件
        String filePath = "data.txt";

        // 正确做法:指定 UTF-8 编码
        try (BufferedReader reader = new BufferedReader(
                new InputStreamReader(new FileInputStream(filePath), StandardCharsets.UTF_8))) {
            String line = reader.readLine();
            System.out.println("Read Line: " + line);
        }
    }
}
当输入文件实际为 GBK 编码时使用 UTF-8 会发生什么
如果源文件实际上是 GBK 编码,但程序强行使用 UTF-8 进行读取或转换,结果会出现乱码。这是因为 GBK 的双字节结构与 UTF-8 的多字节结构不同,UTF-8 解码器会将错误的字节组合解析为无效的 Unicode 字符或替换字符()。这种情况下,即使代码逻辑完全正确,由于输入数据的编码格式与解码器不匹配,最终输出的字符串依然是不可读的乱码。解决此问题的前提是确认源文件的真实编码,并使用对应的 Charset 进行解码。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


