






PaperOrchestra 是由 Google Cloud AI Research 开发的基于多智能体(Multi-Agent)协作的自动化 AI 学术论文写作框架,旨在将研究者零散的研究想法和实验日志自动转化为符合顶会格式要求的 LaTeX 论文。该工具通过编排大纲生成、文献综述、章节撰写、内容润色及绘图等多个专用 Agent,实现从原始材料到投稿级手稿的端到端处理,但核心逻辑依赖人工提供的结构化输入与最终产物复核。
paperorchestra不是完全不用管的全自动黑盒,你得提前整理好所有研究素材,每一步生成的内容都要手动校验,下面我们把它的核心工作流、材料准备和常见报错排查都讲清楚。
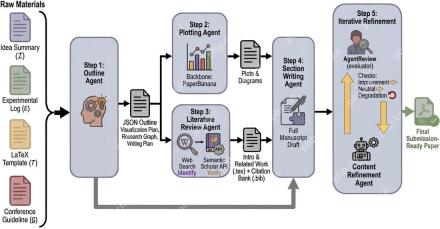
理解 PaperOrchestra 的多智能体协作架构
不启用绘图的写作路径主要由大纲、文献、章节和润色阶段组成。启用绘图后会进入额外的图表工作流。
- Outline Agent(大纲智能体):负责解析研究者的原始想法,结合目标会议的模板要求,生成结构化的论文大纲 JSON 文件。
- HybridLiterature Agent(混合文献智能体):基于大纲自动搜索相关文献,进行优先级排序并整合进参考文献库,同时更新 LaTeX 模板中的引用占位符。
- Section Writing Agent(章节撰写智能体):依据大纲、文献综述结果以及实验日志,逐章生成初步的 LaTeX 草稿文本。
- Content Refinement Agent(内容润色智能体):对初稿进行反思与润色,检查逻辑连贯性与学术规范,最终输出 PDF 文件。
各阶段会读取上游材料和中间产物。出现内容偏差时,可按运行日志回到对应阶段核对输入与输出。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
准备研究者输入材料
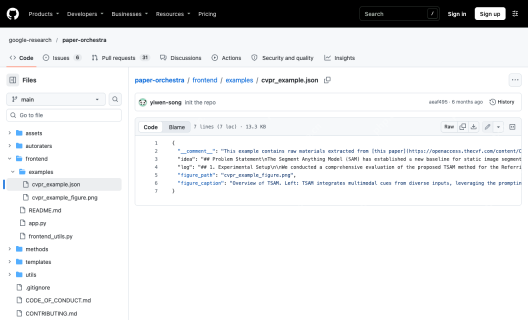
PaperOrchestra没法凭空攒出符合要求的论文,所有内容都高度依赖你提前准备好的原材料。按照代码逻辑,输入目录必须包含两个核心 Markdown 文件和一个可选的图片目录。
必需的文件结构
从 CLI 使用时,构想文件默认名为 idea_sparse.md,实验日志为 experimental_log.md。
idea_sparse.md 需要详细描述研究背景、假设、方法创新点及预期贡献。experimental_log.md 则应包含具体的实验设置、超参数、结果表格及关键发现。这两个文件的质量直接决定了 Outline Agent 生成的骨架是否合理,以及 Section Writing Agent 填充内容的准确性。
LaTeX 模板适配
你需要提供目标会议(如 CVPR, NeurIPS 等)的 LaTeX 模板文件夹。该文件夹内必须包含 template.tex 和 guidelines.md。guidelines.md 描述了该会议的排版规范,Agent 会读取此文件以确保生成的论文符合格式要求。若模板缺失这两个文件,程序将在第一步抛出断言错误。
产物复核与常见问题排查
就算全流程自动化跑通了,你也一定要对关键产出做人工复核,大语言模型很容易生成不存在的内容,或者漏掉重要的实验细节。
关键产物检查清单
- 按运行日志定位大纲产物,检查章节顺序和研究问题是否与原材料一致。
- references.bib:位于 LaTeX 输出目录。检查引用的文献是否相关,是否存在伪造的引用条目(Hallucination)。这是 AI 写作中最常见的风险点。
常见故障排除
模板需包含 template.tex 和 guidelines.md。CLI 文件名不同时用 --idea_filename 与 --experimental_log_filename 显式指定。
API 超时或配额错误时,先根据日志定位模型端或文献服务端,检查对应权限和额度后再决定是否重跑。
绘图失败时检查绘图阶段日志和原始实验数据,确认数据、代码及图片引用是否完整。已有图表可使用 --use_plotting false。













