






java 日志记录要实现集中管理,核心做法是将应用产生的日志事件通过异步方式发送到远程日志聚合服务(如 elk stack、loki 或 splunk),而不是直接写入本地文件。具体实现通常涉及引入日志传输客户端(如 logstash forwarder/filebeat 或 fluentd),配置日志输出格式为结构化 json,并在应用中集成对应的 appender 或 logger 适配器。这样做可以将分散在各服务器上的日志统一收集、存储和检索,便于后续进行故障排查和数据分析。

如何配置 Java 应用输出结构化 JSON 日志
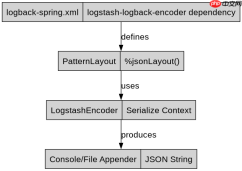
要让日志聚合系统能高效解析,Java 应用必须输出标准的 JSON 格式日志,而非传统的纯文本行。这可以通过在 Spring Boot 项目中添加 logstash-logback-encoder 依赖来实现。该库允许将日志上下文(如线程名、类名、MDC 变量)自动序列化为 JSON 字段。配置时,需在 logback-spring.xml 中定义一个自定义的 PatternLayout,使用 %jsonLayout() 转换器,并指定需要包含的关键字段。这样输出的每一行日志都是一个合法的 JSON 对象,便于 Filebeat 等采集器读取并转发给 Logstash。
<dependency><groupid>net.logstash.logback</groupid><artifactid>logstash-logback-encoder</artifactid><version>7.4</version></dependency>
<appender name="JSON_CONSOLE" class="ch.qos.logback.core.ConsoleAppender"><encoder class="net.logstash.logback.encoder.LogstashEncoder"></encoder></appender><root level="INFO"><appender-ref ref="JSON_CONSOLE"></appender-ref></root>
运行上述配置后,控制台输出将变为类似 {"@timestamp":"...","level":"INFO","logger":"com.example.Service","message":"Processing request"} 的结构化数据。这种格式确保了时间戳、级别和消息体被明确标记,避免了正则解析的复杂性。开发者只需关注业务逻辑中的日志调用,无需手动拼接 JSON 字符串,从而保证日志数据的完整性和一致性。
如何通过 Filebeat 将日志转发至 Elasticsearch
在应用层输出 JSON 日志后,下一步是部署日志采集代理(Agent)将本地文件推送到中央存储。Filebeat 是轻量级的日志 Shipper,适合安装在每个 Java 应用服务器上。它监控指定的日志文件路径,逐行读取新内容,解析 JSON 结构,并将其批量发送给 Elasticsearch 或 Logstash。配置 Filebeat 时,需定义 inputs 指向 Java 应用的日志文件路径,设置 json.keys_separator 以展开嵌套字段,并配置 output.elasticsearch 指向集群地址。Filebeat 还会处理日志文件的轮转(rotation),确保在日志文件切换时不丢失数据。


filebeat.inputs:
- type: log
  enabled: true
  paths:
    - /var/log/myapp/*.log
  json.keys_under_root: true
  json.add_error_key: true

output.elasticsearch:
  hosts: ["http://localhost:9200"]
  index: "myapp-logs-%{+yyyy.MM.dd}"
启动 Filebeat 后,它会持续监听 /var/log/myapp/ 目录下的日志文件。当 Java 应用产生新的 JSON 日志行时,Filebeat 会立即捕获并发送。Elasticsearch 接收到数据后,会根据索引模板自动映射字段类型。例如,@timestamp 会被识别为日期类型,level 为关键字类型。这种自动化映射使得在 Kibana 中查询特定级别的错误日志变得简单直观,无需预先定义复杂的 Schema。
如何在日志中包含 MDC 上下文信息以追踪请求链路
在微服务架构中,单个请求可能跨越多个服务,因此需要在日志中嵌入唯一的请求 ID(Trace ID)以便追踪。Java 日志框架支持 Mapped Diagnostic Context (MDC),允许开发者将上下文数据绑定到当前线程。通过在拦截器或过滤器中生成 UUID 并存入 MDC,所有后续的日志调用都会自动携带该 ID。配合 logstash-logback-encoder,可以配置 MdcJsonProvider 将 MDC 中的键值对作为顶层字段输出到 JSON 日志中。这样,聚合后的日志系统中,用户可以通过搜索 Trace ID 来串联起整个请求链路上的所有相关日志事件。
// 在 Spring Interceptor 中
@Override
public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler) {
    String traceId = UUID.randomUUID().toString();
    MDC.put("traceId", traceId);
    return true;
}

@Override
public void afterCompletion(HttpServletRequest request, HttpServletResponse response, Object handler, Exception ex) {
    MDC.clear();
}
当应用运行时,生成的 JSON 日志中将包含 "traceId":"550e8400-e29b-41d4-a716-446655440000" 字段。在 Kibana 中,用户可以输入 traceId: 550e8400-e29b-41d4-a716-446655440000 来过滤出与该请求相关的所有日志。这种方法不仅简化了分布式系统的调试过程,还提高了生产环境问题的定位效率。开发者无需修改业务代码中的日志打印语句,只需确保 MDC 在请求开始时初始化并在结束时清理即可。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


