






javascript 的 web worker 无法直接传递 idbcursorwithvalue,因为该对象持有对数据库事务和游标的内部引用,不具备结构化克隆(structured clone)所需的可序列化属性。要跨线程处理游标数据,必须在主线程中通过循环将游标指向的记录提取为纯数据对象(如 json),然后使用 postmessage() 发送这些对象;worker 收到后,若需写回数据库,应创建新的独立事务进行写入,而非复用原游标。
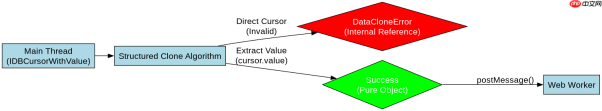
为什么 IDBCursorWithValue 不能被 postMessage 序列化?
因为 IDBCursorWithValue 是 IndexedDB API 中的非标准扩展接口,其核心功能依赖于当前打开的数据库连接和活跃的事务上下文。结构化克隆算法仅支持基本类型、数组、普通对象以及部分内置对象(如 Date、Map),不支持包含内部 C++ 指针或特定浏览器引擎状态的 DOM/Storage 对象。尝试直接发送会导致 DataCloneError。
// 主线程代码
const dbRequest = indexedDB.open('MyDB', 1);
dbRequest.onsuccess = (event) => {
  const db = event.target.result;
  const transaction = db.transaction(['items'], 'readonly');
  const store = transaction.objectStore('items');
  const cursorRequest = store.openCursor();

  cursorRequest.onsuccess = (e) => {
    const cursor = e.target.result;
    if (cursor) {
      // 错误做法:直接发送 cursor
      // worker.postMessage(cursor); // 抛出 DataCloneError

      // 正确做法:提取 value 并发送
      worker.postMessage({
        type: 'process-data',
        data: cursor.value // 假设 value 是纯对象
      });

      cursor.continue();
    }
  };
};
上述代码展示了标准的提取模式。我们只发送 cursor.value,这是由开发者定义的数据结构,可以被安全克隆。如果 value 本身包含嵌套的非序列化对象(如 Blob 或 ArrayBuffer),则需进一步转换或使用 structuredClone 预处理。
Worker 如何处理接收到的数据并写回数据库?
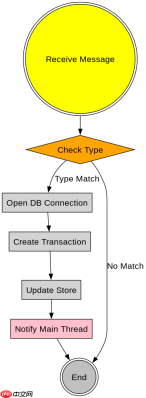
Worker 接收到数据后,由于它没有原始数据库连接的句柄,必须自行建立新的连接和事务来完成写操作。这意味着不能简单地“更新”原游标指向的记录,而是需要执行一次完整的读写流程:打开数据库、开启事务、查找记录、修改并提交。这种设计保证了线程隔离,避免了并发事务冲突。

// Worker 代码
self.onmessage = async (e) => {
  if (e.data.type === 'process-data') {
    const item = e.data.data;

    // 模拟数据处理
    item.processed = true;
    item.timestamp = Date.now();

    // Worker 内部重新打开数据库
    const request = indexedDB.open('MyDB', 1);
    request.onsuccess = (event) => {
      const db = event.target.result;
      const tx = db.transaction(['items'], 'readwrite');
      const store = tx.objectStore('items');

      // 注意:这里需要根据 key 或其他唯一标识来更新
      // 通常需要在主线程传递 key,或者在 value 中包含 key
      const updateRequest = store.put(item);

      updateRequest.onsuccess = () => {
        self.postMessage({ status: 'updated', id: item.id });
      };
    };
  }
};
此段代码演示了 Worker 端的完整闭环。关键点在于 indexedDB.open 在 Worker 中是异步且独立的。如果数据量较大,建议分批发送,避免阻塞主线程 UI 渲染。同时,确保 item 中包含用于定位记录的 key 或唯一字段,否则 store.put() 可能插入重复数据。
基于游标遍历条件过滤的具体问题如何解决?
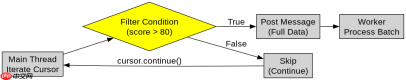
当需要在 Worker 中根据复杂条件过滤游标数据时,最佳实践是在主线程完成初步筛选,或将所有必要数据发送给 Worker 进行内存计算。由于 Worker 无法访问原游标的 continue(key) 方法,不能在 Worker 中直接控制游标的迭代位置。因此,应在主线程使用 cursor.continue() 配合条件判断,仅将符合条件的 value 发送给 Worker。
// 主线程:带条件的过滤
const filterCondition = (val) => val.score > 80;

function processCursor(cursor) {
  if (!cursor) return;

  if (filterCondition(cursor.value)) {
    worker.postMessage({
      type: 'filter-result',
      data: cursor.value
    });
  }

  cursor.continue();
}

cursorRequest.onsuccess = (e) => {
  processCursor(e.target.result);
};
这种模式确保了只有满足业务逻辑的数据才会进入 Worker 队列,减少了通信开销。如果过滤逻辑极其复杂,可以考虑在主线程预计算索引,或在 Worker 中加载全量数据进行批量处理,具体取决于数据规模和实时性要求。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





