






java 中利用 pdf 库生成文档的核心做法是:先通过文件读写 api(如 fileoutputstream)获取输出流,再实例化 pdf 库的文档对象并绑定该流,随后向文档中添加内容并调用关闭方法。以 apache pdfbox 为例,使用 pddocument 类创建空白文档,将其与 fileoutputstream 关联后,即可通过 pdpagecontentstream 写入文本或图形,最后调用 document.close() 将数据刷入文件。若需处理已存在的 pdf 模板,则应先使用 pddocument.load() 加载文件,修改后再保存。
如何初始化 PDF 文档并绑定输出流
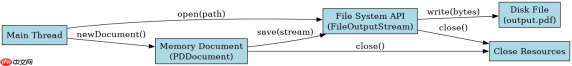
初始化 PDF 文档的关键在于正确建立内存中的文档对象与磁盘文件的连接。在 Apache PDFBox 中,这通过 PDDocument 类的静态工厂方法 newDocument() 实现,该方法返回一个空的 PDF 容器。为了将生成的内容持久化,需要创建一个指向目标路径的 FileOutputStream 对象。虽然 PDDocument 本身不直接持有流,但在后续操作如保存时,通常会将流作为参数传入,或者在自动资源管理块中确保流的生命周期与文档一致。这种绑定方式确保了所有对文档对象的修改最终都能通过流写入到指定的文件中。
import org.apache.pdfbox.pdmodel.PDDocument;
import java.io.FileOutputStream;
import java.io.IOException;

public class PdfInitExample {
    public static void main(String[] args) {
        String filePath = "output.pdf";
        try (PDDocument document = PDDocument.newDocument();
             FileOutputStream outputStream = new FileOutputStream(filePath)) {

            // 此时文档已创建,流已打开
            // 可以在这里添加页面和内容
            document.addPage(new org.apache.pdfbox.pdmodel.PDPage());

            // 将文档内容写入输出流
            document.save(outputStream);

        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}
上述代码展示了初始化的标准流程。首先导入必要的 PDDocument 和 FileOutputStream 类。在 try-with-resources 语句中,同时声明了 PDDocument 和 FileOutputStream,这保证了即使发生异常,资源也会被正确释放。通过 PDDocument.newDocument() 创建空文档,并通过 new FileOutputStream(filePath) 指定输出位置。在块内部,添加了一个空白页面,然后调用 document.save(outputStream) 将内存中的 PDF 结构序列化并写入文件。预期结果是当前目录下生成一个名为 output.pdf 的文件,其内容为单页空白 PDF。
如何在生成的文档中写入文本内容
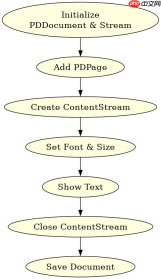
在文档初始化并绑定流之后,下一步通常是向页面中添加内容。PDFBox 使用 PDPageContentStream 来处理具体的绘制操作,包括文本、图像和矢量图形。要写入文本,需要先获取文档中的当前页面,然后创建一个 PDPageContentStream 实例,并将其与页面和文档关联。在内容流中,必须设置字体和字号,因为 PDF 标准要求所有文本渲染都基于特定的字体资源。通过 setFont() 和 setFontSize() 配置样式后,使用 showText() 方法输入字符串。需要注意的是,每次写入文本前可能需要调整坐标,默认原点通常在左下角。完成所有文本操作后,必须关闭内容流以提交更改,最后再次保存文档以确保更新生效。


import org.apache.pdfbox.pdmodel.PDDocument;
import org.apache.pdfbox.pdmodel.PDPage;
import org.apache.pdfbox.pdmodel.PDPageContentStream;
import org.apache.pdfbox.pdmodel.font.PDType1Font;
import java.io.FileOutputStream;
import java.io.IOException;

public class PdfWriteTextExample {
    public static void main(String[] args) {
        String filePath = "text_output.pdf";
        try (PDDocument document = PDDocument.newDocument();
             FileOutputStream outputStream = new FileOutputStream(filePath)) {

            PDPage page = new PDPage();
            document.addPage(page);

            try (PDPageContentStream contentStream = new PDPageContentStream(document, page)) {
                contentStream.setFont(PDType1Font.HELVETICA_BOLD, 12);
                contentStream.beginText();
                contentStream.newLineAtOffset(100, 700); // 设置起始坐标
                contentStream.showText("Hello, PDF World!");
                contentStream.endText();
            }

            document.save(outputStream);

        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}
此代码演示了文本写入的具体实现。在创建文档和页面后,进入第二个 try-with-resources 块以管理 PDPageContentStream。使用 PDType1Font.HELVETICA_BOLD 选择内置字体,大小为 12 点。通过 beginText() 开始文本模式,newLineAtOffset(100, 700) 将光标移动到页面右上区域,避免文字被截断。showText() 实际写入字符串 "Hello, PDF World!"。结束文本模式后关闭内容流。最终生成的 text_output.pdf 将包含这一行加粗的 Helvetica 文本。如果未调用 endText() 或忘记关闭内容流,文本可能不会正确渲染或导致文件损坏。
当文件路径不存在时会发生什么
当指定的文件路径所在的目录不存在时,FileOutputStream 的构造函数会抛出 java.io.FileNotFoundException。这是因为 Java 的文件系统 API 不会自动创建中间目录层级。在 PDF 生成的上下文中,这意味着在尝试绑定输出流之前,必须确保目标路径的父目录已经存在。如果在 try-catch 块中没有捕获这个异常,程序将终止,且不会生成任何 PDF 文件。解决这个问题的标准做法是在创建流之前,检查父目录是否存在,如果不存在则使用 File.mkdirs() 创建它。这样可以确保 FileOutputStream 能够成功打开文件句柄,从而允许后续的 PDF 写入操作正常进行。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


