






使用 java.nio.charset.standardcharsets 枚举和 string 构造函数或 getbytes() 方法可以简化 java 字符编码操作,避免硬编码字符串带来的运行时异常。直接引用标准编码常量并配合字节数组转换,即可在 utf-8、iso-8859-1 等常见编码间安全切换。

如何避免硬编码字符串导致的 UnsupportedEncodingException
通过引入 StandardCharsets 类,开发者可以直接使用类型安全的常量替代字符串字面量,从而消除检查型异常的处理负担。在创建新字符串或获取字节数组时,传入这些常量对象即可确保编码名称的正确性且无需捕获异常。
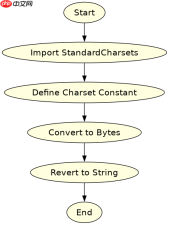
import java.nio.charset.StandardCharsets;
import java.nio.charset.Charset;

public class EncodingDemo {
    public static void main(String[] args) {
        String original = "Hello World";

        // 使用 StandardCharsets.UTF_8 替代 "UTF-8"
        byte[] bytes = original.getBytes(StandardCharsets.UTF_8);

        // 解码时使用相同的常量
        String decoded = new String(bytes, StandardCharsets.UTF_8);

        System.out.println("Decoded: " + decoded);
    }
}
上述代码展示了最基础的转换流程。输入字符串 Hello World 被转换为字节数组,随后又还原为字符串。由于使用了 StandardCharsets,编译器和运行环境都能保证编码名称的合法性,省去了传统的 try-catch 块。预期输出为 Decoded: Hello World,且程序不会抛出 UnsupportedEncodingException。
如何处理非 UTF-8 编码的数据交互
在处理遗留系统或特定协议数据时,常需使用 ISO-8859-1 或 GBK 等编码。利用 Charset.forName() 或预定义的 StandardCharsets 常量,可以灵活指定目标编码格式,实现不同字符集间的正确映射。


import java.nio.charset.StandardCharsets;
import java.nio.charset.Charset;

public class LegacyEncodingDemo {
    public static void main(String[] args) {
        String text = "Test Data";

        // 模拟从 ISO-8859-1 来源读取数据
        Charset isoCharset = StandardCharsets.ISO_8859_1;
        byte[] data = text.getBytes(isoCharset);

        // 假设需要转换为 GBK 存储
        Charset gbkCharset = Charset.forName("GBK");
        byte[] gbkData = new String(data, isoCharset).getBytes(gbkCharset);

        System.out.println("Bytes length: " + gbkData.length);
    }
}
该示例演示了跨编码转换的场景。首先将文本按 ISO-8859-1 编码为字节,再将其视为 ISO-8859-1 字符串并按 GBK 重新编码。这种链式处理确保了中间状态的字符完整性。对于 ASCII 兼容字符,各编码字节值相同,但对于扩展字符,结果会有所不同。预期输出显示字节长度,具体数值取决于字符内容,但关键在于转换过程无异常且符合预期编码规范。
当输入包含特殊字符时编码行为有何差异
当输入字符串包含超出目标编码范围的字符(如中文在 ISO-8859-1 中)时,不同编码处理方式会导致数据丢失或替换。使用 StandardCharsets 能明确这种行为边界,帮助开发者预判数据完整性风险。
import java.nio.charset.StandardCharsets;

public class SpecialCharDemo {
    public static void main(String[] args) {
        String chinese = "中文";

        // UTF-8 能完整保留
        byte[] utf8Bytes = chinese.getBytes(StandardCharsets.UTF_8);
        String utf8Back = new String(utf8Bytes, StandardCharsets.UTF_8);

        // ISO-8859-1 无法表示中文,通常替换为 ? 或丢失
        byte[] isoBytes = chinese.getBytes(StandardCharsets.ISO_8859_1);
        String isoBack = new String(isoBytes, StandardCharsets.ISO_8859_1);

        System.out.println("UTF8 Match: " + chinese.equals(utf8Back));
        System.out.println("ISO Match: " + chinese.equals(isoBack));
    }
}
此段代码验证了特殊字符在不同编码下的表现。UTF-8 编码支持 Unicode 全字符集,因此往返转换后字符串完全一致,输出 true。而 ISO-8859-1 仅支持西欧字符,中文字符在转换过程中会被替换为默认替换字符(通常为 ?),导致往返转换后字符串不一致,输出 false。开发者应据此选择正确的编码工具,避免静默的数据损坏。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


