






starlette 通过 streamingresponse 处理流式响应,核心做法是传入一个异步可迭代对象(如生成器或异步生成器),框架会在客户端连接期间逐块发送数据。开发者只需在视图函数中定义包含 yield 的异步函数,并将其实例化为 streamingresponse 返回即可。若需自定义 mime 类型或头部信息,可在构造函数中指定 media_type 和 headers 参数。
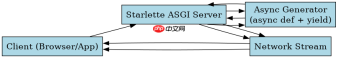
如何构建基础的异步流式响应
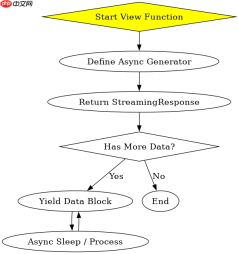
构建基础流式响应的关键在于使用 Python 的异步生成器(async def + yield)来产生数据块。Starlette 会自动遍历该生成器,将每次 yield 出的字节串写入 HTTP 响应体并立即发送给客户端。这种方式避免了将所有数据加载到内存中,非常适合大文件传输或实时日志推送场景。以下代码展示了如何创建一个简单的流式响应,其中数据块按顺序生成。
import asyncio
from starlette.applications import Starlette
from starlette.responses import StreamingResponse
from starlette.routing import Route

async def stream_data(request):
    async def data_generator():
        for i in range(5):
            yield f"Chunk {i}: Hello\n".encode()
            await asyncio.sleep(0.1)  # 模拟延迟以观察流式效果
    return StreamingResponse(data_generator())

app = Starlette(routes=[Route("/stream", stream_data)])
运行上述代码后,访问 /stream 端点,客户端会依次收到五个数据块。每个块都是独立的字节串,中间由 await asyncio.sleep 引入微小延迟,这能直观体现流式传输的特性:数据不是一次性到达,而是分批次抵达。这种实现方式确保了即使数据量很大,服务器内存占用也保持恒定。
如何处理自定义头部与媒体类型
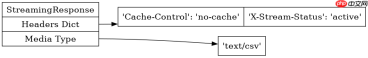
在处理流式响应时,默认媒体类型通常为 text/html,但在许多场景下(如 JSON 流、CSV 导出或 SSE),需要明确指定 media_type 和额外的 HTTP 头部。通过在实例化 StreamingResponse 时传入 headers 字典,可以覆盖默认的 Content-Type 或添加 Cache-Control 等指令。这对于确保客户端正确解析流内容至关重要,例如告诉浏览器不要缓存部分更新的 CSV 文件。

import asyncio
from starlette.responses import StreamingResponse

async def csv_stream(request):
    async def generate_csv():
        yield "id,name\n".encode()
        for i in range(3):
            yield f"{i},User{i}\n".encode()
            await asyncio.sleep(0.05)

    headers = {
        "Cache-Control": "no-cache",
        "X-Stream-Status": "active"
    }
    return StreamingResponse(
        generate_csv(),
        media_type="text/csv",
        headers=headers
    )
执行此代码时,客户端接收到的响应头将包含 Content-Type: text/csv; charset=utf-8 以及自定义的 X-Stream-Status。这种灵活性允许开发者根据具体业务需求调整 HTTP 协议层面的元数据,而无需修改底层的数据生成逻辑。需要注意的是,头部信息必须在响应开始发送前确定,因为一旦第一个数据块发出,HTTP 头部即被锁定。
当异步生成器抛出异常时响应会怎样
当异步生成器在迭代过程中抛出未捕获的异常时,Starlette 会中断当前的流式传输,并向客户端发送一个错误状态码(通常是 500 Internal Server Error)。此时,已经发送的部分数据可能已被客户端接收,但后续数据将不再传输。如果需要在发生错误时优雅地关闭连接或记录日志,可以在生成器内部使用 try...except 块包裹 yield 语句,或者在视图层捕获异常并返回标准的错误响应对象,从而避免直接暴露堆栈跟踪给客户端。








