






java 日志记录通过结构化输出(如 json)配合 elk 或 grafana loki 等可视化平台,将非结构化文本转化为可查询、可图表化的指标数据。具体做法是在代码中使用 logback 或 log4j2 配置 patternlayout 输出包含时间戳、级别、线程名及自定义字段的 json 格式日志,随后由采集器解析并推送到后端存储,最终在前端仪表盘展示。

如何配置日志输出为 JSON 格式
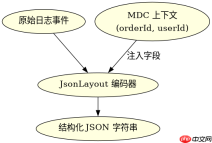
要实现可视化,第一步是将默认的纯文本日志转换为机器可读的结构化数据。以 Spring Boot 项目为例,通常使用 Logback 作为日志实现。需要引入 logstash-logback-encoder 依赖,并在 logback-spring.xml 中替换默认的 PatternLayout 为 JsonLayout。这样每次调用 logger.info() 时,控制台或文件输出的不再是散乱的字符串,而是一行完整的 JSON 对象,其中包含了 MDC(Mapped Diagnostic Context)中的上下文信息,便于后续提取关键字段。
{
  "dependencies": {
    "ch.qos.logback": "logback-classic:1.4.11",
    "net.logstash.logback": "logstash-logback-encoder:7.3"
  },
  "config": {
    "appender": "CONSOLE",
    "layout": "JsonLayout",
    "includeMdc": true
  }
}
上述配置确保了日志事件被封装为标准 JSON。在实际开发中,建议在业务逻辑开始前通过 MDC.put("userId", id) 注入关键业务 ID,这些字段会自动出现在生成的 JSON 日志中,成为可视化的维度依据。若不使用第三方编码器,也可手动构建 JSON 字符串,但推荐使用成熟库以保证转义和性能。
如何将结构化日志接入可视化平台
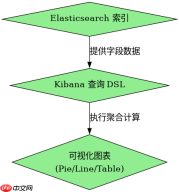
生成 JSON 日志后,需要将其传输到支持可视化的后端系统。常见的方案是使用 Filebeat 或 Fluent Bit 采集本地日志文件,解析 JSON 内容后发送至 Elasticsearch 或 Loki。以 Elasticsearch 为例,Filebeat 的 json.message_key 配置可以自动将 JSON 中的字段扁平化为 ES 文档的字段。这样,原本的一行日志文本就变成了具有明确字段类型(如 keyword, date, long)的数据记录,可以直接用于 Kibana 或 Grafana 的聚合查询和图表绘制。

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.slf4j.MDC;

public class LogService {
    private static final Logger logger = LoggerFactory.getLogger(LogService.class);

    public void processOrder(String orderId, String userId) {
        // 设置 MDC 上下文,用于 JSON 日志输出
        MDC.put("orderId", orderId);
        MDC.put("userId", userId);
        try {
            logger.info("Processing order started");
            // 模拟业务逻辑
            if (orderId == null || orderId.isEmpty()) {
                throw new IllegalArgumentException("Invalid order ID");
            }
            logger.info("Order processed successfully");
        } catch (Exception e) {
            logger.error("Order processing failed", e);
        } finally {
            // 清理 MDC 防止内存泄漏
            MDC.clear();
        }
    }

    public static void main(String[] args) {
        LogService service = new LogService();
        service.processOrder("ORD-123", "USER-456");
    }
}
运行上述程序,控制台将输出类似如下格式的 JSON 日志:
{"timestamp":"2023-10-27T10:00:00.000+08:00","level":"INFO","message":"Processing order started","orderId":"ORD-123","userId":"USER-456"}
该数据被 Filebeat 抓取并索引到 Elasticsearch 后,即可在 Kibana 中创建 Dashboard。例如,创建一个 Pie Chart,按 level 字段聚合,直观展示 INFO 与 ERROR 日志的比例;或创建一个 Line Graph,按 @timestamp 聚合,观察单位时间内订单处理量的趋势。这种从代码到可视化的链路,核心在于结构化的中间态数据。
日志可视化中如何处理异常堆栈信息
在可视化展示中,异常堆栈(Stack Trace)通常较长且包含换行符,直接存入搜索引擎可能导致字段截断或解析错误。Logstash 或 Filebeat 提供了专门的 grok 或 multiline 处理器来处理这种情况。对于基于 JSON 输出的日志,如果使用了 StackTraceAsArray 布局,异常堆栈会被拆分为数组元素,每个元素作为一个独立的字符串值存储在 JSON 中。这种方式在可视化时更为友好,因为前端可以直接遍历数组展示每一行堆栈,或者在搜索时精确匹配某一行异常信息。若不采用数组形式,则需确保采集器配置了正确的多行合并规则,将分散在多行的堆栈重新拼接为一个完整的字段值,以便在可视化面板中完整显示错误详情。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


