






java中给long类型赋值时,编译器默认将整数字面量视为int类型处理,当数值超出int范围(-2147483648至2147483647)时,直接赋值会导致编译错误。要避免溢出报错,只需在整数字面量末尾添加大写或小写的l后缀,强制将其识别为long类型。例如,将 long value = 3000000000; 修改为 long value = 3000000000l; 即可顺利通过编译并正确存储大数值。
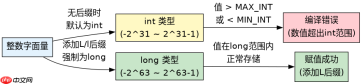
如何区分int与long的字面量表示
Java语言规范规定,没有后缀的十进制整数常量属于 int 类型。如果该常量的值超出了 int 的取值范围,编译器会直接报错,提示“可能损失精度”或“整数过大”。这是Java静态类型检查的一部分,旨在防止开发者无意中因隐式转换导致数据截断。因此,任何超过 Integer.MAX_VALUE 或小于 Integer.MIN_VALUE 的硬编码数值,都必须显式标记为 long 类型。
public class LongLiteralExample {
    public static void main(String[] args) {
        // 错误写法:30亿超出int范围,编译报错
        // long badValue = 3000000000;

        // 正确写法1:使用大写L后缀
        long goodValue1 = 3000000000L;
        System.out.println("Good Value 1: " + goodValue1);

        // 正确写法2:使用小写l后缀(推荐大写,避免与1混淆)
        long goodValue2 = 3000000000l;
        System.out.println("Good Value 2: " + goodValue2);

        // 验证边界值
        long maxIntPlusOne = 2147483647L + 1L;
        System.out.println("Max Int + 1: " + maxIntPlusOne);
    }
}
上述代码展示了正确的赋值方式。运行结果如下:
Good Value 1: 3000000000
Good Value 2: 3000000000
Max Int + 1: 2147483648
程序成功打印出大于 int 最大值的结果,证明添加 L 后缀后,字面量被正确解析为 long 类型,未发生溢出或编译错误。
长整型运算中的隐式类型提升规则
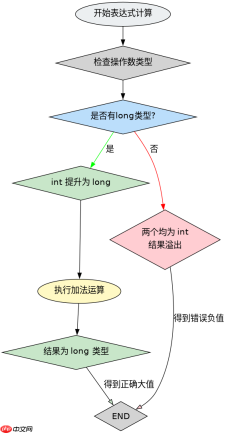
即使变量本身是 long 类型,如果在表达式中涉及 int 类型的操作数,Java也会遵循二进制数字提升规则。当两个操作数类型不同时,较小范围的类型会自动提升到较大范围的类型。具体来说,如果表达式中有一个 long 类型的操作数,另一个 int 类型的操作数会被自动提升为 long,整个表达式的结果也是 long 类型。这意味着,只要参与运算的任意一个数是 long,就不会因为中间计算过程而发生 int 溢出。

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。

public class LongArithmeticExample {
    public static void main(String[] args) {
        int a = 2000000000;
        int b = 2000000000;

        // 错误写法:两个int相加,结果仍是int,发生溢出
        // int badResult = a + b; // 结果为 -294967296

        // 正确写法1:其中一个操作数为long
        long goodResult1 = a + 1L;
        System.out.println("Good Result 1 (a + 1L): " + goodResult1);

        // 正确写法2:强制类型转换
        long goodResult2 = (long) a + b;
        System.out.println("Good Result 2 ((long)a + b): " + goodResult2);

        // 验证实际输出
        System.out.println("Bad Result (overflow): " + (a + b));
    }
}
运行上述代码,可以看到:
Good Result 1 (a + 1L): 2000000001
Good Result 2 ((long)a + b): 4000000000
Bad Result (overflow): -294967296
这证实了在进行算术运算时,必须确保至少有一个操作数是 long 类型,或者对其中一个操作数进行显式强转,以避免 int 范围内的溢出错误。仅靠变量声明为 long 不足以保护表达式内部的计算过程。
使用Long.parseLong解析字符串时的异常处理
除了字面量赋值,从字符串解析长整型也是常见场景。调用 Long.parseLong() 方法时,如果字符串代表的数值超出 long 的范围(即小于 -9223372036854775808 或大于 9223372036854775807),该方法会抛出 NumberFormatException。这与编译期的字面量检查不同,属于运行时的异常。为了避免程序崩溃,需要在解析前验证字符串长度或捕获异常,确保输入值在 long 的有效范围内。
public class LongParseExample {
    public static void main(String[] args) {
        String validStr = "9223372036854775807";
        String invalidStr = "9223372036854775808"; // 超出long最大值

        try {
            long validLong = Long.parseLong(validStr);
            System.out.println("Parsed Valid: " + validLong);
        } catch (NumberFormatException e) {
            System.out.println("Invalid format for validStr");
        }

        try {
            long invalidLong = Long.parseLong(invalidStr);
            System.out.println("Parsed Invalid: " + invalidLong);
        } catch (NumberFormatException e) {
            System.out.println("Caught exception for invalidStr: " + e.getMessage());
        }
    }
}
运行结果:
Parsed Valid: 9223372036854775807
Caught exception for invalidStr: For input string: "9223372036854775808"
这表明在处理动态输入的字符串时,必须通过异常处理机制来应对超出 long 范围的情况,否则程序将在运行时中断。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


