






在 nginx 中实现主备节点的自动故障转移,核心做法是结合 upstream 模块的 health_check 功能与 keepalive 连接池。通过配置 upstream 块定义后端服务器组,并启用健康检查指令,nginx 会定期探测后端节点状态;当主节点响应失败或超时,流量会自动切换至备用节点,从而实现高可用。
upstream 模块如何定义主备服务器组
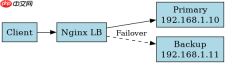
upstream 模块通过 server 指令定义后端服务器列表,默认行为即为主备模式。第一个 server 为主节点,后续 server 为备用节点。Nginx 优先将请求发送给主节点,仅在主节点不可用时才转向备用节点。这种配置无需额外参数即可实现基本的故障转移逻辑。
upstream backend {
    server 192.168.1.10:8080; # 主节点
    server 192.168.1.11:8080 backup; # 备用节点
}

server {
    listen 80;
    location / {
        proxy_pass http://backend;
    }
}
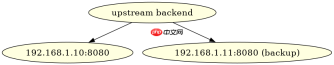
上述配置中,192.168.1.10 为主节点,192.168.1.11 标记为 backup。当主节点宕机时,Nginx 自动将请求转发至 192.168.1.11。恢复后,流量重新切回主节点。此配置适用于简单的主备场景,但缺乏主动健康检查机制。
health_check 如何实现主动故障检测
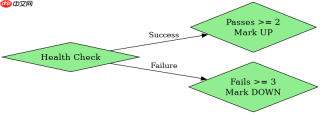
health_check 指令允许 Nginx 主动探测后端节点的健康状态,而非依赖被动连接失败。通过设置 interval 和 timeout 参数,可控制探测频率和超时时间。当节点连续探测失败次数超过阈值时,Nginx 将其标记为 down,并停止向其发送请求。

upstream backend {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080 backup;

    health_check interval=5 fails=3 passes=2;
}

server {
    listen 80;
    location / {
        proxy_pass http://backend;
    }
}
该配置中,interval=5 表示每 5 秒探测一次,fails=3 表示连续 3 次失败标记为 down,passes=2 表示连续 2 次成功恢复为 up。相比被动检测,主动探测能更快发现故障并切换流量,提升系统可用性。
当主节点恢复时,流量如何重新分配
当主节点从 down 状态恢复时,Nginx 会根据 health_check 的 passes 参数逐步恢复流量。一旦连续探测成功次数达到 passes 阈值,主节点重新加入上游服务器组,Nginx 优先将新请求发送至主节点。此过程平滑且无需重启服务,确保业务连续性。


